Linux Slab 与 Slub 分配器机制:kmem_cache 源码走读与内存对象复用
Linux Slab 与 Slub 分配器机制:kmem_cache 源码走读与内存对象复用
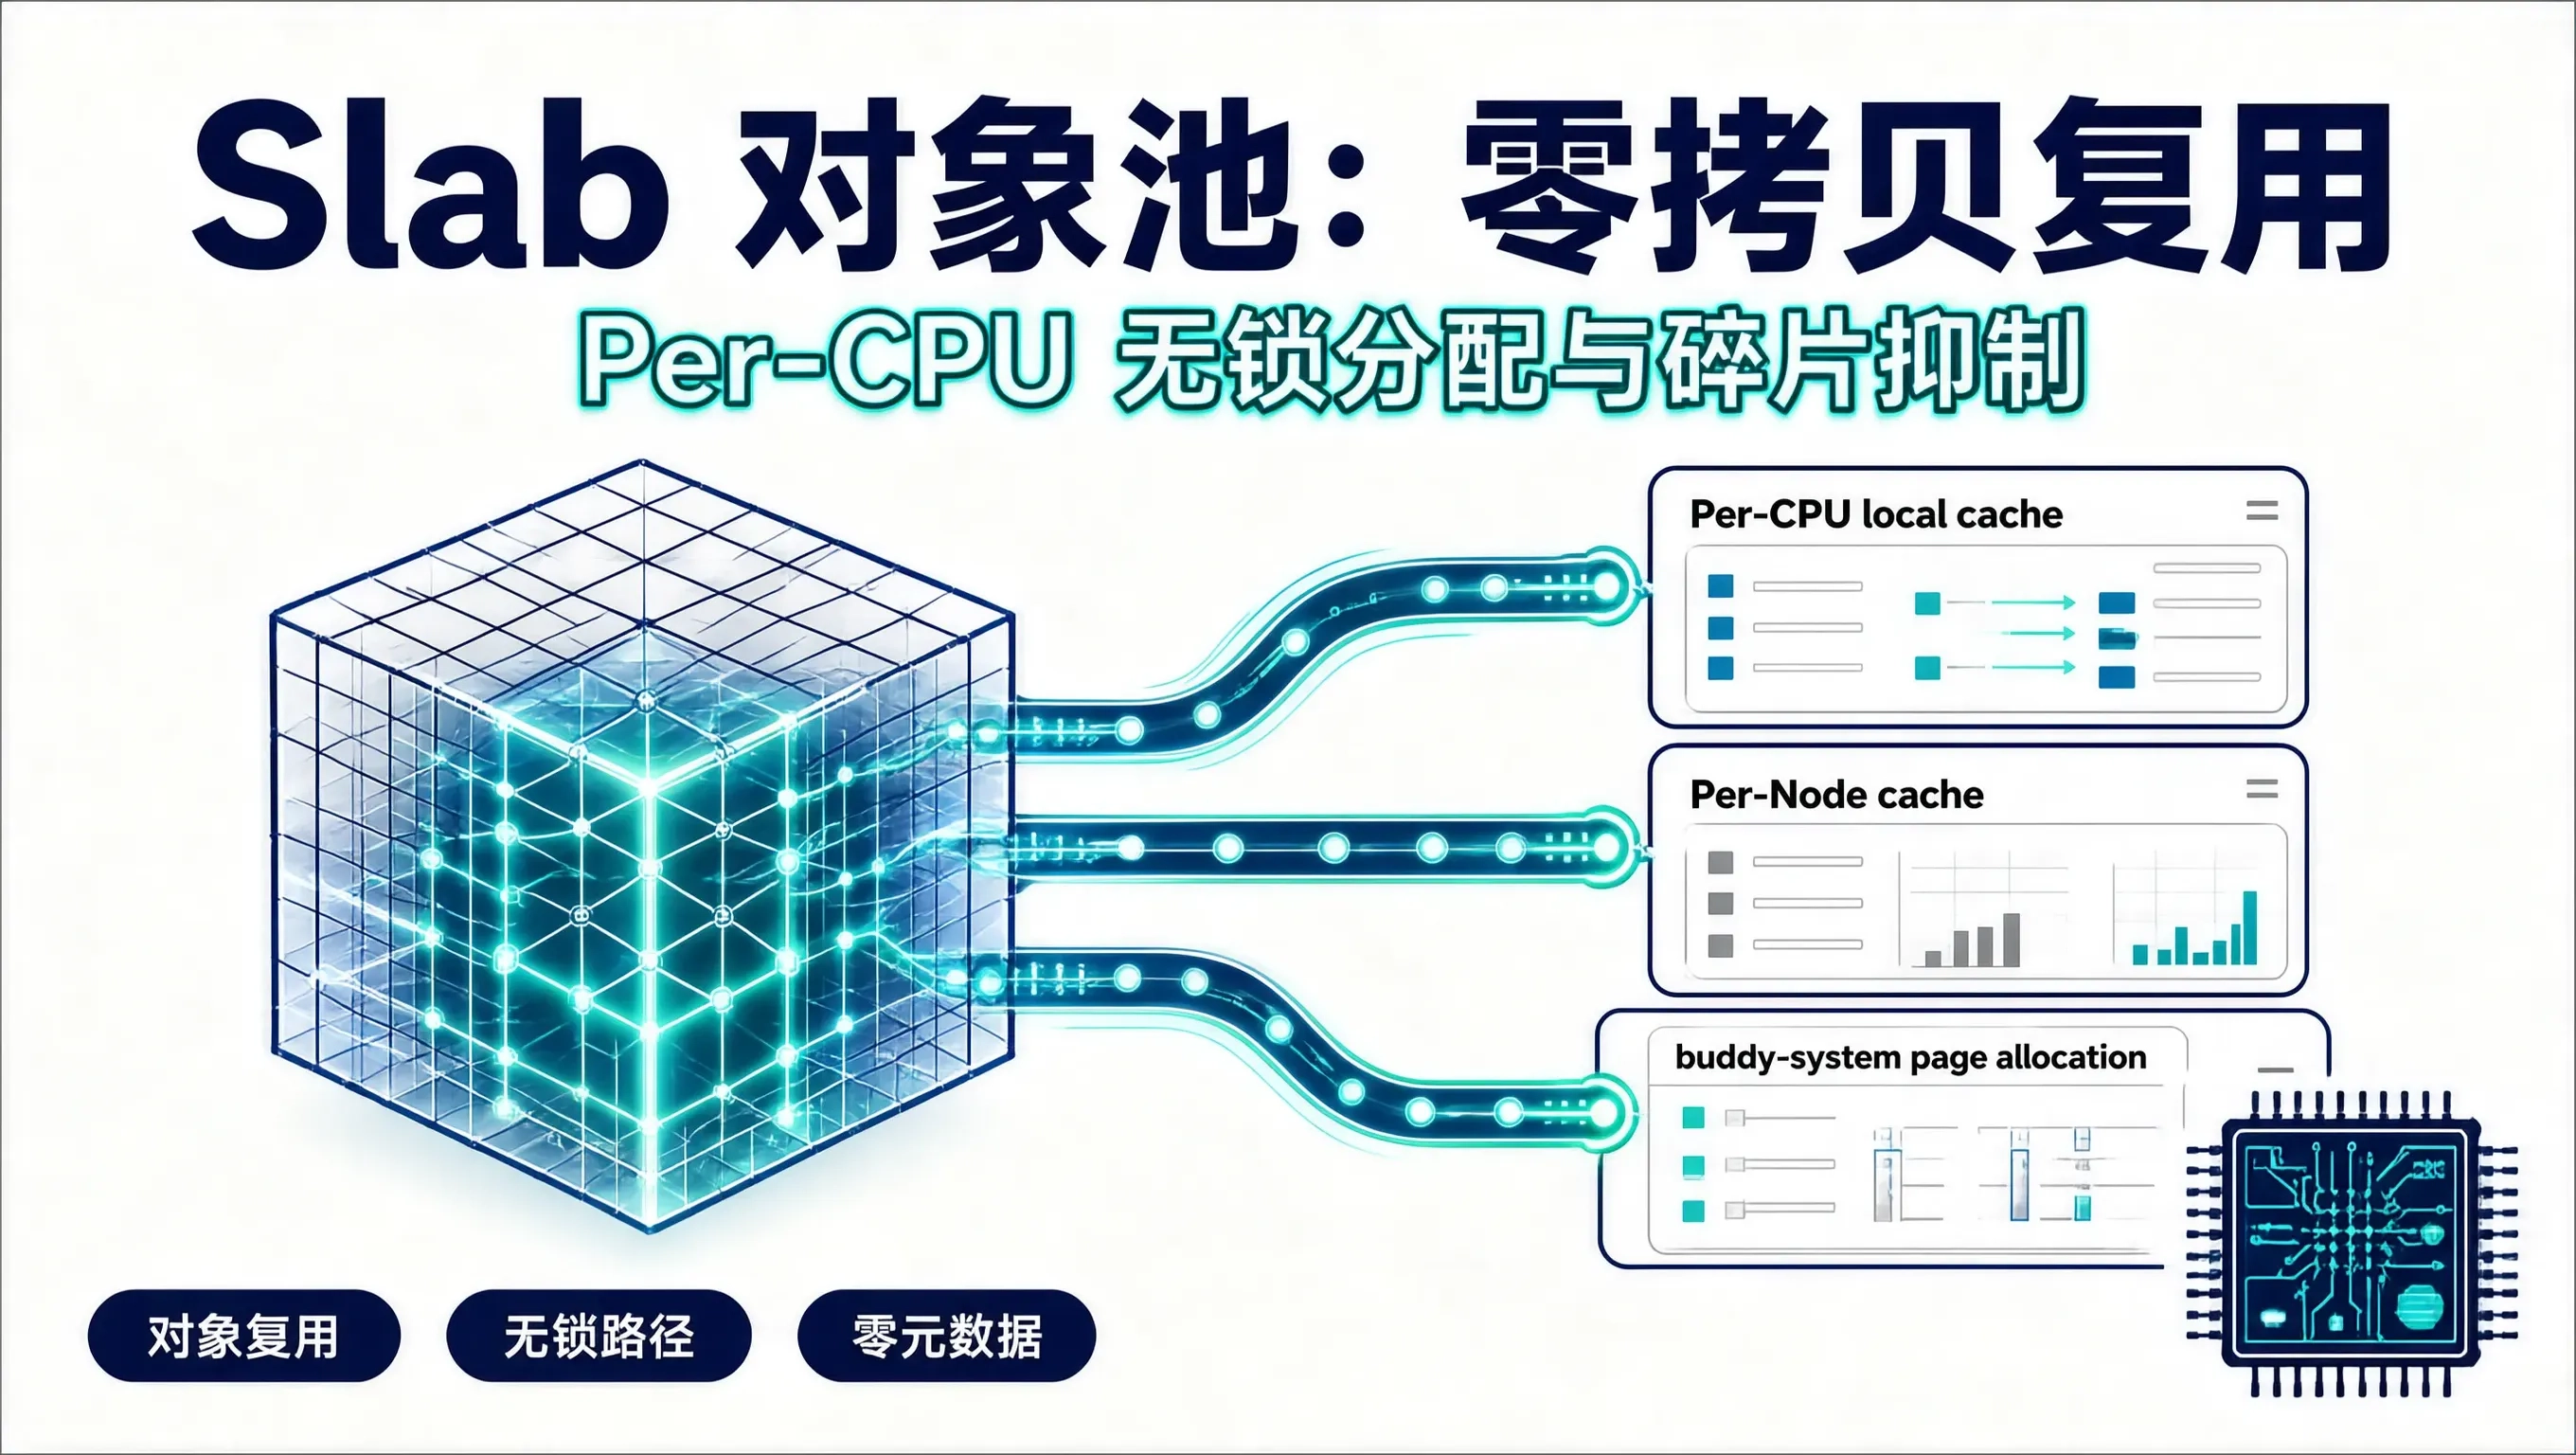
在 Linux 操作系统中,伙伴系统(Buddy System)负责管理整个物理内存的分配,但其最小管理粒度是整整一个物理页(通常为 4KB)。
然而在内核日常运行中,充斥着海量极小数据结构的频繁创建与销毁:一个 struct inode 约几百字节,一个网络收发包的 struct sk_buff 约 200 字节,一个进程的 struct task_struct 约几 KB。如果每一次分配小对象都向伙伴系统申请一个 4KB 页面,不仅会造成高达 90% 以上的内部碎片(Internal Fragmentation),更会导致频繁的 TLB 刷新与内存初始化开销。
为了解决小内存对象的高性能复用与碎片抑制问题,Linux 内核引入了基于对象池机制的 Slab / Slub 分配器。
一、从 Slab 到 Slub:内核设计哲学的演进
最初由 Jeff Bonwick 提出的经典 Slab 分配器在多核高并发场景下逐渐暴露了瓶颈:每个 Cache 需要维护庞大的描述符队列(Full、Partial、Empty 三链表),元数据内存开销巨大且伴随着复杂的自旋锁竞争。
现代 Linux 内核(默认采用 Slub 分配器)对架构进行了极致的精简与无锁化优化:
【struct kmem_cache 核心拓扑】
        │
        ├──► [Per-CPU 局部缓存: struct kmem_cache_cpu] (快速无锁路径)
        │      ├── freelist 指针 ──► [Object 1] ──► [Object 2] ──► NULL (空闲对象链)
        │      └── page 指针     ──► 当前正在分配的物理页 (struct page)
        │
        └──► [Per-Node 节点缓存: struct kmem_cache_node] (慢速路径兜底)
               ├── partial 链表 ──► [Page A (部分使用)] ──► [Page B]
               └── list_lock 自旋锁
Slub 分配器的两大核心创新:
- 零外部元数据开销(Zero Metadata Overhead):Slub 彻底移除了独立的 slab 描述符,直接将空闲链表指针(
freelist)保存在空闲对象本身的内存首地址上。当对象被分配出去时,这块内存被业务数据覆盖;当对象释放回池中时,重新写回链表指针。 - Per-CPU 极致无锁快速路径:每个 CPU 核心独占一个
kmem_cache_cpu结构,只要当前 CPU 的freelist中有可用对象,单次分配仅需几条汇编指令,全程无锁(Lockless)。
二、kmem_cache 核心数据结构源码走读
在内核源码 include/linux/slub_def.h 与 mm/slub.c 中,核心定义如下:
/* 每 CPU 局部缓存结构体 */
struct kmem_cache_cpu {
    void **freelist;      /* 指向当前 CPU 本地下一个可用空闲对象的指针 */
    unsigned long tid;    /* 事务 ID,用于实现无锁并发检测 (cmpxchg_double) */
    struct page *page;    /* 当前正在提供分配的 Slub 页面 */
};

/* 内核小对象高速缓存池描述符 */
struct kmem_cache {
    struct kmem_cache_cpu __percpu *cpu_slab; /* Per-CPU 局部缓存指针 */

    /* 核心属性 */
    slab_flags_t flags;
    unsigned long min_partial;
    unsigned int size;            /* 对象实际占用大小 (包含对齐与填充) */
    unsigned int object_size;     /* 对象纯业务大小 */
    struct kmem_cache_order_objects oo; /* 每次向伙伴系统申请页面时的 order 阶数与对象数 */

    /* 构造函数:初始化新对象时调用 */
    void (*ctor)(void *);

    /* NUMA 节点缓存 */
    struct kmem_cache_node *node[MAX_NUMNODES];
};
三、kmem_cache_alloc 源码执行路径剖析
当内核调用 kmem_cache_alloc(cachep, flags) 时,执行流程被严格区分为快速路径(Fastpath)与慢速路径(Slowpath):
kmem_cache_alloc()
       │
       ▼
[进入 slab_alloc_node 快速路径]
       │
       ├── 1. 读取当前 CPU 的 c = this_cpu_ptr(s->cpu_slab)
       ├── 2. 获取 object = c->freelist
       │
       ├────► [object != NULL?]
       │         │
       │         ├── 是 ──► [Fast Path 命中]
       │         │           - 将 c->freelist 更新为 object 的下一个节点: *(void **)object
       │         │           - 直接返回 object (耗时仅 ~10ns, 零锁竞争!)
       │         │
       │         └── 否 ──► [Fast Path 缺失]
       │                     │
       ▼                     ▼
[跌入 __slab_alloc 慢速路径]
       │
       ├── 3. 当前 CPU 页面用尽,从 node->partial 链表中尝试获取一个包含空闲对象的页面
       ├── 4. 若 partial 链表亦为空,调用伙伴系统 alloc_pages() 申请全新的物理页
       ├── 5. 按照 s->size 将新页面切分成等长 Object,串成 freelist
       └── 6. 挂载到当前 CPU 的 cpu_slab 并返回对象
四、生产环境 Slab 观测与泄漏排查实战
在高负载 Linux 服务器或端侧网关上,Slab 缓存占用过多会导致可用内存枯竭。
4.1 观测内核 Slab 占用
# 1. 实时查看内核 Slab 对象占用排行榜 (按内存消耗排序)
$ slabtop -s c

# 2. 输出示例:
 Active / Total Objects (% used)    : 1420500 / 1450000 (97.9%)
 Active / Total Size (% used)       : 350.2M / 360.5M (97.1%)

  OBJS ACTIVE  USE OBJ SIZE  SLABS OBJ/SLAB CACHE SIZE NAME
480000 478000  99%    0.58K  30000       16    281.2M radix_tree_node
250000 248000  99%    0.20K  12500       20     50.0M dentry
120000 119000  99%    0.10K   3000       40     12.0M buffer_head
 45000  42000  93%    0.62K   3750       12     28.1M inode_cache
4.2 典型生产问题治理:Dentry / Inode Cache 膨胀
当服务器频繁遍历或创建大量临时文件时,目录项缓存 dentry 与索引节点缓存 inode_cache 会迅速吃满数十 GB 内存。
虽然内核在内存紧缺时会自动回收(Reclaim),但在需要紧急释放缓存时,可通过向 /proc/sys/vm/drop_caches 写入控制指令强制收回 Slab 缓存:
# 强制内核收回未使用的 Slab 缓存 (dentry, inode)
sync
echo 2 > /proc/sys/vm/drop_caches

# 调整 Slab 回收意愿积极程度 (默认 100,增大至 200 会加速内核回收 VFS 缓存)
echo 200 > /proc/sys/vm/vfs_cache_pressure
深入理解 Slub 分配器的 Per-CPU 局部缓存与无锁对象池模型,不仅能帮助系统工程师精准分析内核内存的真实分布,更能将这种极致的“对象复用与零拷贝”设计思想反哺到用户态高并发服务的数据结构设计中。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献57条内容

所有评论(0)