Linux系统篇,进程概念(五):进程切换的研究、O(1)调度算法的数据结构和细节体现
系列文章目录
`
文章目录
前言
你有没有想过: 在一个 CPU 核心上,成千上万的进程是怎么 “同时” 跑起来的? 一段死循环代码写出来,为什么没有把整台电脑锁死?
这背后是操作系统里一套极其精巧的机制 ——进程调度。今天这篇文章,就从进程之间的关系讲起,一路拆解到 Linux 经典的 O (1) 调度器,把这套底层逻辑彻底讲透。
一、进程间的关系
操作系统里同时跑着大量进程,它们之间存在四个核心特性:
- 竞争性
CPU 资源是有限的,但进程数量是无限的。大家都想抢 CPU,于是就产生了竞争。
为了解决 “谁先谁后” 的问题,操作系统引入了进程优先级—— 给每个进程一个权重,决定它在排队时排前面还是排后面。
- 独立性
每个进程拥有自己独立的地址空间和资源,运行时互不干扰。你在浏览器里崩了,不会直接把记事本带崩。
- 并行(多 CPU 才谈得上)
当你有多个物理 CPU 核心时,多个进程可以在同一时刻真正同时执行 —— 这叫并行。
- 并发(单 CPU 也能做到)
只有一个 CPU 核心怎么办?操作系统用进程切换的方式,在一段时间内快速来回切换,让每个进程都得到推进。宏观上看像是 “同时运行”,微观上其实是轮流使用 CPU—— 这叫并发。
二、进程切换的预备知识
上面我们在谈及并发时,有个关键概念:进程切换,让我们想想一个场景开始关键话题的讲解:
一个进程一旦占住 CPU,会不会一直把全部代码跑完?
2.1 进程时间片的享有
我们上节曾说:Linux是分时操作系统,具有时间片轮转的机制。那么上面的问题答案就显而易见了。
不会 ,操作系统会给每个进程分配一个时间片(比如 1ms)。时间片用完,操作系统就强制把它 "剥离"CPU,放回就绪队列重新排队。
所以哪怕你写了一个
while(1)死循环,它也不会永久霸占 CPU—— 时间片一到就被踢出去了。这就是为什么死循环卡死不了整个系统。
2.2 CPU寄存器
进程的执行离不开CPU大量的逻辑判断、算数运算及内存读取与覆写,那CPU是如何做到的呢?就是“寄存器”的作用了。
2.2.1 寄存器的定义与作用
我们知道CPU在运算时,需要不断的对PCB指向的数据和代码修改,而修改后的数据如果覆写到内存之后再从内存取出,那这也太费时间了,于是为了节约时间:寄存器应运而生。
- 寄存器定义: 寄存器是 CPU 内部高速存储单元,用来临时存放指令、数据、地址。
- 寄存器作用: 利用 CPU 内部极高速的存储空间,尽量减少访问内存,提升 CPU 执行速度;同时保存程序执行的控制信息。
2.2.2 寄存器的种类
- 通用寄存器:存放运算的数据,程序可以读写(eax、ebx 等 x86;R0‑R31 ARM)
- 程序计数器 PC (IP):存下一条要取的指令的地址;取完指令自动 +
- 指令寄存器 IR:存放当前正在执行的指令,对程序员透明,不能直接访问
- 程序状态字 PSW / 标志寄存器 FLAGS:保存运算结果状态(溢出、零、正负、进位标志)
- 地址寄存器 MAR:内存地址;数据寄存器 MDR:和内存交互的数据
2.2.3 寄存器的内容
寄存器并非是内存的拓展,而是CPU的临时仓库,它储存的是当前进程的数据,用于完成进程的任务。
关键认知:寄存器 ≠ 寄存器里的数据。 寄存器是 CPU 内部的临时存储位置,里面装的是当前进程的运行现场
我们又知道一个进程在CPU上运行的时间有限,那么进程没运行完毕,寄存器中的值会怎么办,运算未完毕的结果又会怎么样呢?
让我们开始真正了解进程切换吧!
三、进程上下文与具体切换
3.1 进程上下文定义
进程上下文就是进程运行时的全部环境信息;当进程被切换出去,需要把当前所有现场保存下来,下次重新调度回来时,恢复这些信息,进程就可以接着继续执行。
环境信息:硬件 + 软件硬件如:寄存器中运行到哪行代码 、软件如:进程PID 页表等
它由三个部分组成:
- 寄存器上下文(硬件上下文):通用寄存器、PC 程序计数器、PSW 状态寄存器、栈指针。(最核心,进程切换的时候首先保存这一组)
- 用户级上下文: 进程的页表、虚拟地址空间(程序段、数据段、栈、堆)
- 系统级上下文: PCB 里的管理信息{进程 id、优先级、打开文件、信号掩码等}。
3.2 进程切换
3.2.1 情景引入
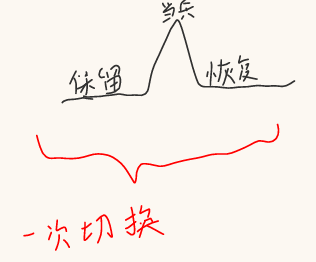
我们从一个 “张嘎”当兵 的故事来体会进程的切换:
张嘎是个大二学生,想要保家卫国于是去当兵。他去当兵的第一件事是什么?(假设已有资格)
第一件事不是直接走,而是保留学籍记录档案;同理,当兵回来第一件事也就是恢复学籍同步档案,回到大三的状态而不是从大一开始。
在上面的故事中我们可以有这样的角色映射:
- 张嘎:进程 (进行调度的主体)
- 学校:CPU
- 辅导员:调度器
选择切换进程 - 学籍/档案:进程运行的临时数据,进程的上下文数据
事件映射:
- 张嘎当兵: 进程被剥夺下CPU
- 保留学籍记录档案: 保存进程运行的临时数据,进程的上下文数据
- 退役复学: 进程再次获取CPU资源
- 恢复学籍记录档案: 恢复进程运行的临时数据,进程的上下文数据到CPU当中
从上面的过程可以看出:进程的一次上下文保留与恢复就是一次进程切换
3.2.2 进程切换实际情况
对进程切换的情况有个大概了解后,我们来研究下实际情况:
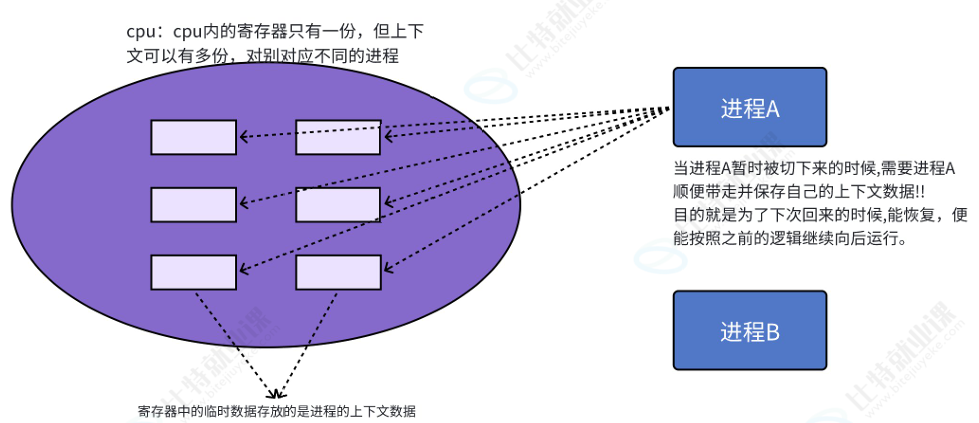
现在有进程A和进程B
3.2.2.1 进程间切换
- 进程A的执行:
进程A得到CPU资源,CPU寄存器已记录其上下文数据;等到A的时间片执行完毕后,OS会将寄存器中的上下文数据拷贝给该进程,A进入进程队列。 - 进程B的执行:
进程B得到CPU资源后,寄存器存储的A数据就可以直接覆写,与A进程之后执行同样操作 - 进程A的恢复:
进程A再次得到CPU资源,将存储的上下文数据拷贝回去,继续执行。
3.2.2.2 上下文数据的保存
我们说上下文数据拷贝到进程中,那这些数据存储在哪里呢?
在Linux的早期代码中,这些硬件上下文是依赖特定的硬件数据结构 TSS(任务状态段) 来管理的:
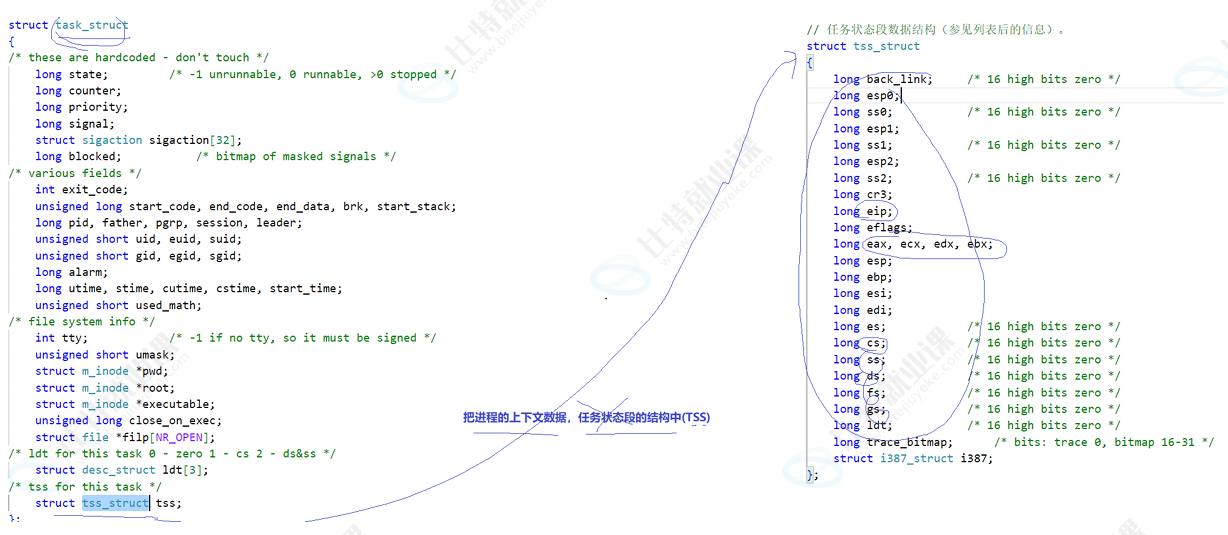
从源代码中看见,进程的task_struct (即PCB)存储着 tss_struct。
而新版 Linux 放弃了 x86 硬件提供的按进程独立 TSS 自动任务切换机制;全局仅保留一份 TSS 用于特权切换时获取内核栈;进程硬件上下文保存于task_struct内嵌的thread_struct,由内核汇编函数__switch_to()以软件方式完成上下文切换,浮点寄存器使用惰性恢复策略降低切换开销;进程的 PID、信号、文件、内存这类软件上下文仍然存放在task_struct及其子结构体中。
3.2.3 进程间的对比:全新进程 vs 调度进程
进程的种类无非两类:未进行执行和执行过的
- 未执行进程: 通过fork函数创建的新的执行流,未获取时间片的进程
- 执行进程: 已活得过CPU资源,且运行过几个时间片的进程
为了便于区分进程,减少对上下文数据的拷贝,OS在PCB中设置状态位:
struct task_struct {
    long state;       // -1 unrunnable, 0 runnable, >0 stopped
    int is_running;   // 状态标记位:是否属于已经运行过的进程
};
并且为了统一性:OS中尚未执行过的进程,软件上下文需要复制(内存使用写时复制,部分资源引用共享);硬件上下文不需要拷贝父进程的寄存器现场,由内核手动初始化生成初始硬件上下文。
3.3 操作系统对比
我们已经对分时操作系统有了一个大概的了解,它的基于时间片的轮转机制,大大的提高了开发效率。而与之相应的还有实时操作系统,它专注于单一进程。
-
分时系统: 将 CPU 划分时间片,轮流服务多个用户进程,实现人机交互;追求良好交互体验,无严格时间限制。通过这样实现进程的公平调度,和并发的执行模式。
-
实时系统: 系统要保证任务严格在规定时限内完成;分为硬实时(超时后果严重)与软实时(偶尔超时可接受),一般使用抢占式优先级调度。
常见的实时系统使用场景:导弹控制系统、汽车自动驾驶控制器
四、O(1) 调度算法与调度队列
我们通过上面的学习已经清楚:进程的切换是怎么进行的以及进程的优先级这些零散的知识,那让我们通过这个调度算法将所学的知识联系起来。
这里给出调度依据的数据结构,从一点点开始剖析: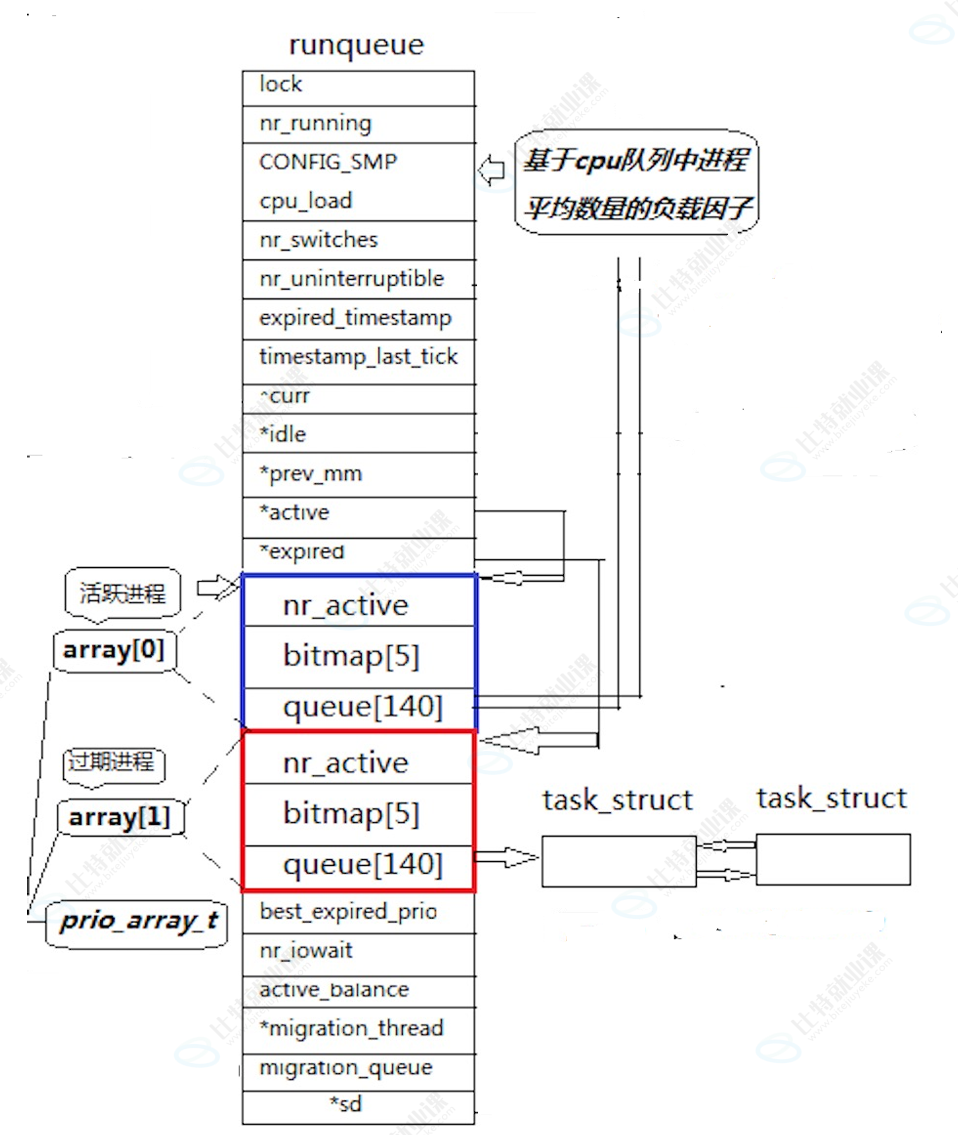
4.1 进程的选择执行
CPU的资源有限,因此当OS中存在大量需要执行的进程时,应该选择哪个去执行?
这个时候就需要进程的优先级去选择了,那我们就需要理解优先级是如何决定运行顺序的,从上面的结构可以看到是通过活跃进程和过期进程来选择的,而我们知道进程 = PCB + 代码数据,而queue[140]这个结构就是存储这些PCB的,其下标对应着优先级[0,140],每一个数组元素都是一个链表的头指针,挂载着所有该优先级下的就绪进程。
这里的指针与进程链表的指针不同:
struct task_struct{
//第一套:用于【总进程链表】,串联系统全部PCB
struct list_head tasks;
//第二套:用于【就绪队列queue[]里面的优先级链表】,只给就绪态用
struct list_head run_list;
};
4.1.1 优先级的划分
我们会有这样的一个疑问:之前学的PIN + NI 的范围不是从[60,99]吗,为什么这里是[0,140]呢?
其实这里的优先级划分分为实时进程与普通进程:
-
实时进程: 对响应时间有严格要求的进程,采用实时调度策略
(SCHED_FIFO、SCHED_RR)。优先级范围1‑99,优先级高于所有普通进程;一旦就绪可以抢占 CPU,优先获得处理器执行,用来处理延迟敏感的任务。 -
普通进程: 一般交互式、后台业务进程,使用 CFS 完全公平调度
SCHED_OTHER。依靠 nice 值调整调度权重,属于软优先级,映射于[100,139];内核尽量公平分配 CPU 时间,没有立刻抢占的硬性保证,适合大多数日常应用。
4.1.2 进程的查找选择
有了优先级数组这个结构,我们选择最重要的进程链,就直接去数组中寻找即可,但是这样从高优先级到低优先级的遍历操作,是不是过于低效了?
于是Linux设计出位图即通过比特位是否置为1来判断是否存在数据,就是图中结构的bitmap[5],一共 32 * 5 = 160 个,用于界定140个优先级是否存在进程绰绰有余。
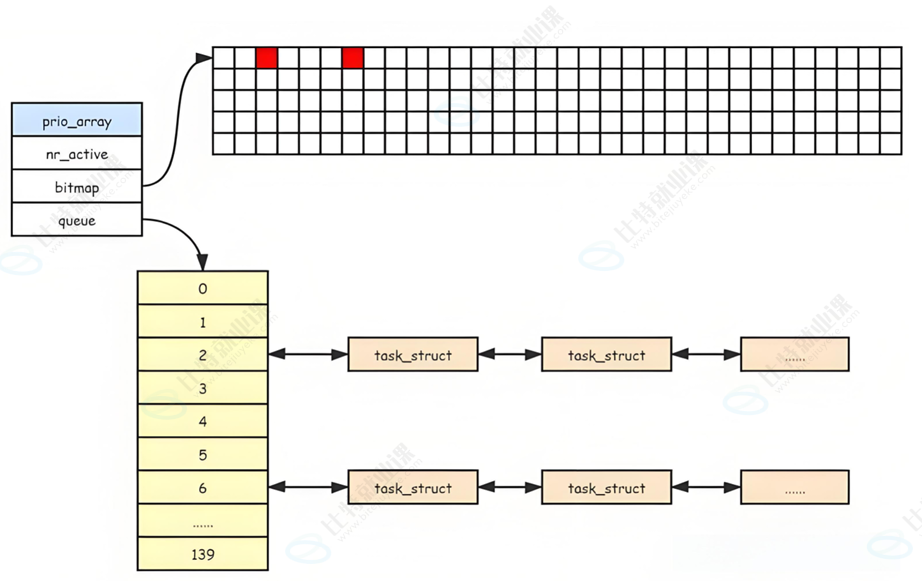
这样的算法只是将 O(140) 优化成 O(5),从O(n) 到 O(1)只是夸张说法。
并且随着CPU的优化升级,已经存在专门的硬件指令来找到数据中最高或最低的比特位为1的地方在哪里,使得不再写软件 for 循环挨个扫下标;调用这个内置函数,借助硬件位扫描指令,直接得到最高置 1 的下标 i。
4.2 活跃队列与过期队列
在上文贴出的数据结构图,我们可以看到:有两个类似的结构。
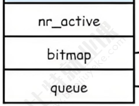
有一个不就可以很好的挑选出适合调度的进程了吗,为什么还需要两个?
这还是因为优先级,优先级高的进程不断产出,那么优先级低的进程就只有很小的机率能得到CPU资源,从而造成进程饥饿。而两者的交替就成功保证了进程执行的公平性。
-
活跃队列:
存放时间片还没有用完的就绪进程;调度器只从 active 里面选进程运行。新创建就绪的进程,放入 active 队列。
并且时间片运行完毕后,就会自动退出该队列进入过期队列。 -
过期队列:
存放时间片已经耗尽的就绪进程;这里面的进程暂时不能参与本轮调度竞争;内核在这里重新计算它的时间片(动态优先级)。
最重要的一点,随着时间推移,活跃队列里的进程越来越少,最终会被清空。(使用一个nr_active来记录进程数量,为0时交换指针)此时,过期队列里则装满了等待运行的进程。当活跃队列为空时,调度器不需要做任何复杂的数据搬移操作,只需要互换一下活跃队列和过期队列的两个指针:
- Swap交换: 交换两个队列中的queue
4.3 细节处理
- “新进程进入活跃队列中,这体现了分时系统的特点”
分时系统特点:新就绪的进程可以立刻参与本轮 CPU 竞争,不需要等到下一轮轮换(不用丢进 expired 过期队列等待)。
- cpu‑load(CPU 负载)
CPU 负载:一段时间内,系统处于就绪(可运行)状态的进程平均数量。
不是 CPU 使用率(%);负载看有多少进程排队等着拿 CPU;O (1) 调度动态优先级计算的时候会参考 cpu‑load,用来抑制 CPU 密集型进程、优待交互式进程。
- ③ “PRI 与 NI 是在进入过期队列时更新优先级的”
分清两个概念
- NI (nice): 是用户设置,静态值,用户改 nice 只是修改 task_struct 里面的 nice 字段,不会立刻改动当前正在使用的 PRI,也不会立刻挪动进程的链表位置。
- PRI(动态优先级 / 实际调度优先级):等到该进程时间片耗尽,从 active 摘除、移入 expired 过期队列的时候,内核才拿当前的 nice + 休眠历史 + cpu‑load,重新算出新的动态 PRI,再挂进 expired 里面对应优先级的链表。
总结
这就是全部内容了,下一节我们将学习系统环境变量。感谢您的阅读,我们下次再见。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)