智能项目管理方法论沉淀(一):从被动催进度到数据驱动的研发闭环
智能项目管理方法论沉淀(一):从被动催进度到数据驱动的研发闭环
很多技术人转做项目管理或技术团队负责人后,最先感受到的挫败感往往不是来自技术难度,而是来自“失控感”:
- 每天晨会每个人都说“今天能搞定”,但到了周五交付日依然一堆阻塞;
- 项目永远停留在“90% 的进度”,而最后的 10% 往往需要消耗前面 90% 的时间;
- 项目经理(PM)沦为“人体闹钟”和“打卡监工”,天天在群里艾特研发追问“这个提测了吗”、“那个联调完了吗”。
在做 Linux 底层内核与驱动开发时,操作系统调度器(Scheduler)从来不需要去“催促”某一个进程,它依靠的是清晰的就绪队列、时间片配额、优先级反转检测与严格的状态机流转。
当我带着操作系统的思维去重构创业团队的项目管理流程时,我意识到:高效的项目管理绝不是靠人肉催出来的,而是通过构建一套自动化、透明、具备自愈与预警能力的工程数据闭环。
过去一年,我们在团队内部逐步落地了这套“智能项目管理体系(IPM v1)”,彻底消灭了被动催进度的低效摩擦。
一、传统研发项目管理的死穴:信息失真与状态滞后
传统项目管理工具(如单纯填写的甘特图或 Jira 任务板)本质上依赖“人工主动上报”。但人性决定了两个不可避免的偏差:
- 乐观偏差(Optimism Bias):工程师在估算工时与汇报进度时,倾向于假设“一切顺利、没有线上紧急 Bug、第三方接口永远稳定”。
- 报喜不报忧机制:当代码在本地联调卡壳时,开发者往往会倾向于“我再调两小时试试”,直到提测截止前一刻才暴露阻塞,导致整个上下游排期瞬间坍塌。
要打破这个死局,核心原则就是数据采集中断化,去除人工汇报环节。研发过程中的每一个真实物理动作(Git 提交、分支合并、CI 构建失败、API 接口变更),都是最客观的系统调用日志(Syscall)。
二、智能度量架构:从物理动作到状态流转
我们构建了一套基于 Webhook 和轻量级 LLM 分析的研发状态监听流水线:
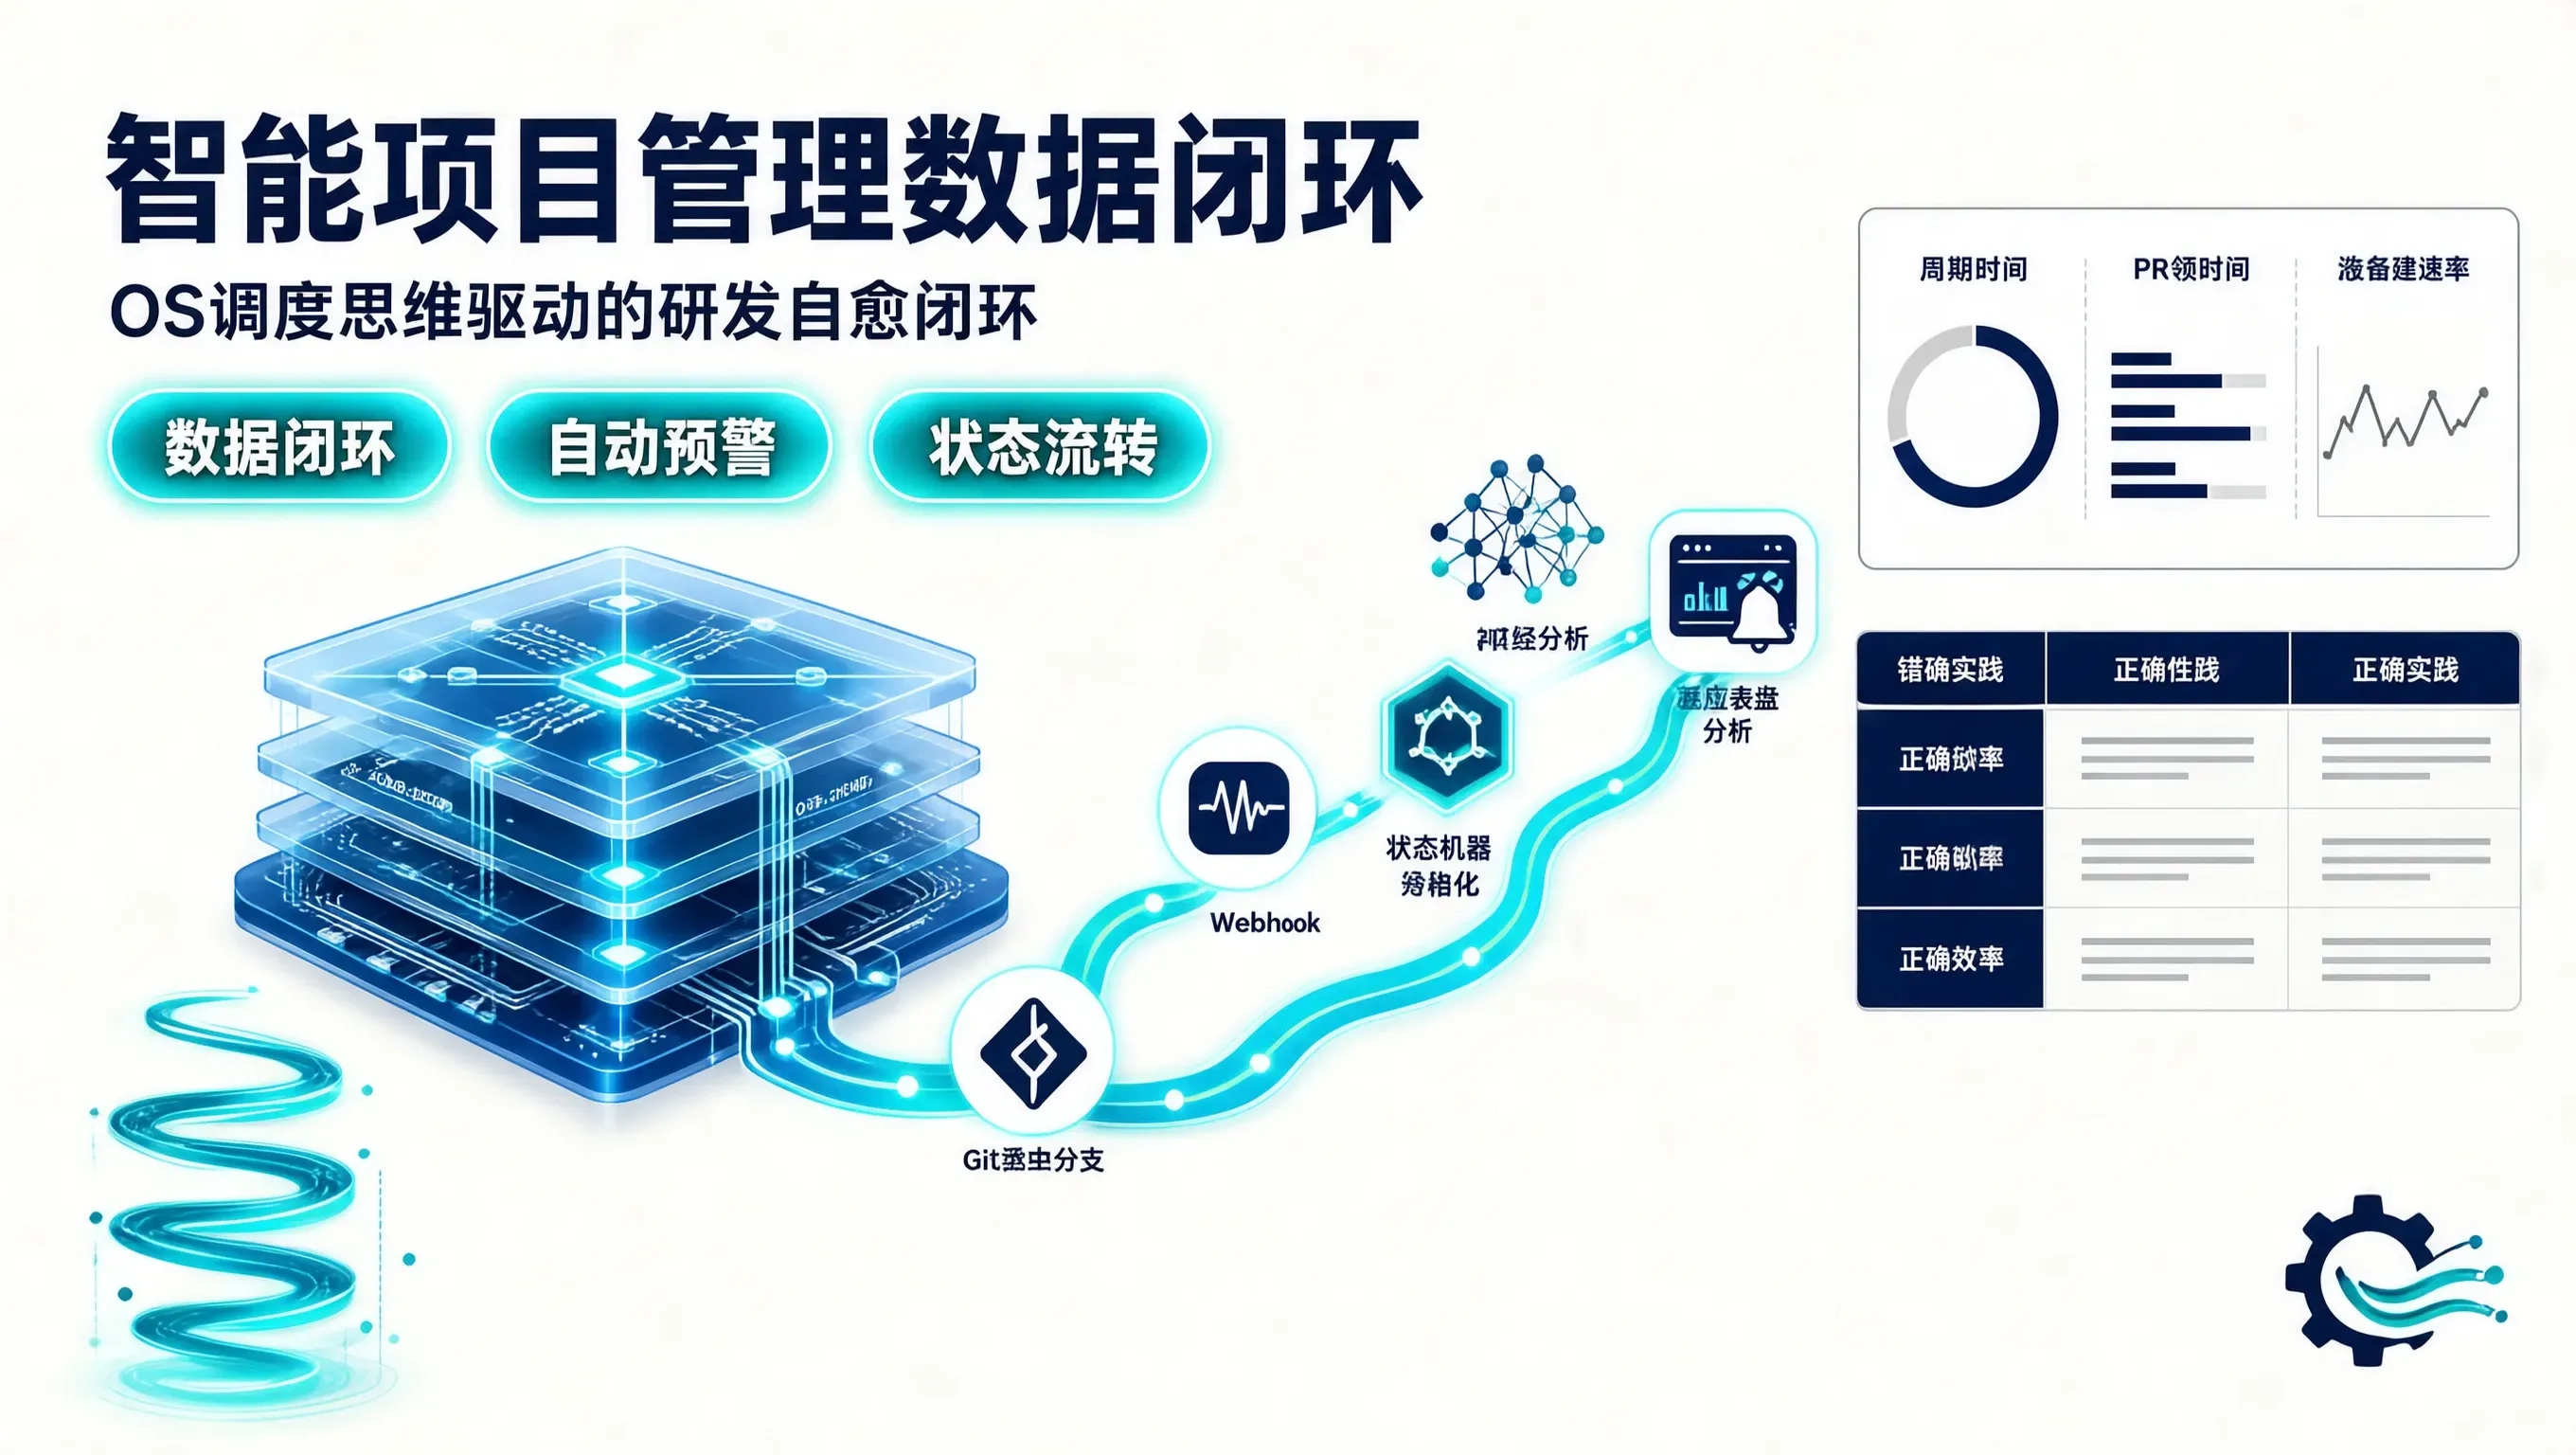
[Git 提交 / PR / Issue] ──> [Webhook Receiver] ──> [状态机事件归一化] ──> [LLM 阻断点归因分析] ──> [自适应看板 / 自动化预警]
核心监控指标(从 OS 调度模型迁移)
- Cycle Time(交付周转时间):从首个 Commit 产生到代码合入主干并成功上线的物理时长。
- PR Lead Time(代码审查停滞时延):PR 处于“Open”状态等待 Review 的时长。若超过 4 个工作小时,自动触发上下文唤醒。
- Flaky Build Rate(构建重试抖动率):CI 构建失败后在未改动业务代码情况下的重试频率,用于识别基础设施负债。
// 研发流水线阻塞点自动监听与分析服务核心逻辑
package main

import (
	"context"
	"fmt"
	"time"
)

type PRState struct {
	RepoName      string
	PRNumber      int
	Author        string
	CreatedAt     time.Time
	Reviewers     []string
	CommentsCount int
	CIStatus      string // SUCCESS, PENDING, FAILED
}

type BlockerAlert struct {
	Severity string // LOW, MEDIUM, CRITICAL
	Message  string
	Action   string
}

func AnalyzePRHealth(ctx context.Context, pr PRState) *BlockerAlert {
	durationOpen := time.Since(pr.CreatedAt)

	// 规则 1: PR 挂起超过 8 小时且 CI 失败,判定为关键阻塞
	if durationOpen > 8*time.Hour && pr.CIStatus == "FAILED" {
		return &BlockerAlert{
			Severity: "CRITICAL",
			Message:  fmt.Sprintf("PR #%d [%s] 持续失败超 8 小时,阻塞主干集成", pr.PRNumber, pr.RepoName),
			Action:   "触发构建日志自动抓取并推送到负责人专属看板",
		}
	}

	// 规则 2: PR 开放超过 24 小时未获任何审查反馈
	if durationOpen > 24*time.Hour && pr.CommentsCount == 0 {
		return &BlockerAlert{
			Severity: "MEDIUM",
			Message:  fmt.Sprintf("PR #%d [%s] 发生审查饥饿(Review Starvation)", pr.PRNumber, pr.RepoName),
			Action:   "根据模块所有权表(CODEOWNERS)动态调优 Reviewer 队列",
		}
	}

	return nil
}
三、引入 LLM 做“精准根因诊断”,而不是写“空话周报”
很多市面上的项目管理工具喜欢用大模型把 Jira 任务生成一篇几千字的流水账。这种功能在技术团队内部基本没人看。
我们对大模型在项目管理中的应用做了极其严苛的边界限定:只做异常归因与跨模块接口契约变动提取。
场景实例:提测前夕多模块联调冲突定位
当三个微服务的分支合并发生联调失败时,自动化系统会将涉及的 3 个仓库的最新 20 次 Commit Diff 提取出 AST 摘要,交由模型进行契约对比:
# 提取模块间 gRPC / Protobuf / HTTP 契约差异的自动化命令流
git log -p -n 5 -- "proto/*.proto" "api/v1/*.json" | ./scripts/parse_contract_diff.sh
LLM 输出的内容绝不是套话,而是极其精炼的技术断言:
[自动预警] 鉴权模块与用户中心存在协议不一致:
- 用户中心在 Commit
a8f3b9c中将user_id类型从int64改为string(UUID 改造);- 鉴权服务 PR #142 中仍沿用
uint64解析 Header,联调失败概率 100%;- 建议行动:拦截鉴权服务合并,指定负责人 @张工 在 30 分钟内完成反序列化适配。
四、从工具到机制:如何让工程师不反感度量
在技术团队推行项目管理度量,最容易踩的坑就是把度量搞成员工绩效考核的“紧箍咒”。一旦度量与 KPI 直接挂钩,工程师就会产生各种防御性行为(比如把一个大 PR 拆成 20 个微小 PR 刷提交量)。
我们的落地法则是**“对事不对人,度量用于暴露系统瓶颈”**:
| 度量维度 | 错误做法(导致对抗) | 正确做法(促进协同) |
|---|---|---|
| 代码提交行数 | 考核个人产出,奖励代码量最多的人 | 监控单次 PR 规模,超过 400 行报警并建议拆分 |
| CI 失败次数 | 惩罚导致构建红灯的工程师 | 统计各模块测试用例执行耗时,识别测试环境脆弱性 |
| 任务延期率 | 晨会当众通报批评 | 分析排期估算模型偏差,自动调优后续同类任务的预估乘数 |
五、阶段性成果与反思
经过两个季度的迭代,团队在不增加任何一名纯职能 PM 的情况下,达成了以下数据:
- 需求平均交付周期(Lead Time)缩短 38%;
- PR 平均等待评审时长从 18.5 小时下降至 3.2 小时;
- 晨会耗时从原本的 30 分钟压缩至 8 分钟(只需针对系统自动标红的 1~2 个真实 Blocker 进行决策)。
把项目管理看作分布式系统的并发调度与锁竞争优化,用确定的代码和数据流替代主观猜测,这不仅是工程思维的胜利,更是让研发团队重获专注与尊严的必由之路。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献66条内容

所有评论(0)