架构演进路线图:从支撑 1 万用户到 100 万用户的技术债治理时间表
·
架构演进路线图:从支撑 1 万用户到 100 万用户的技术债治理时间表
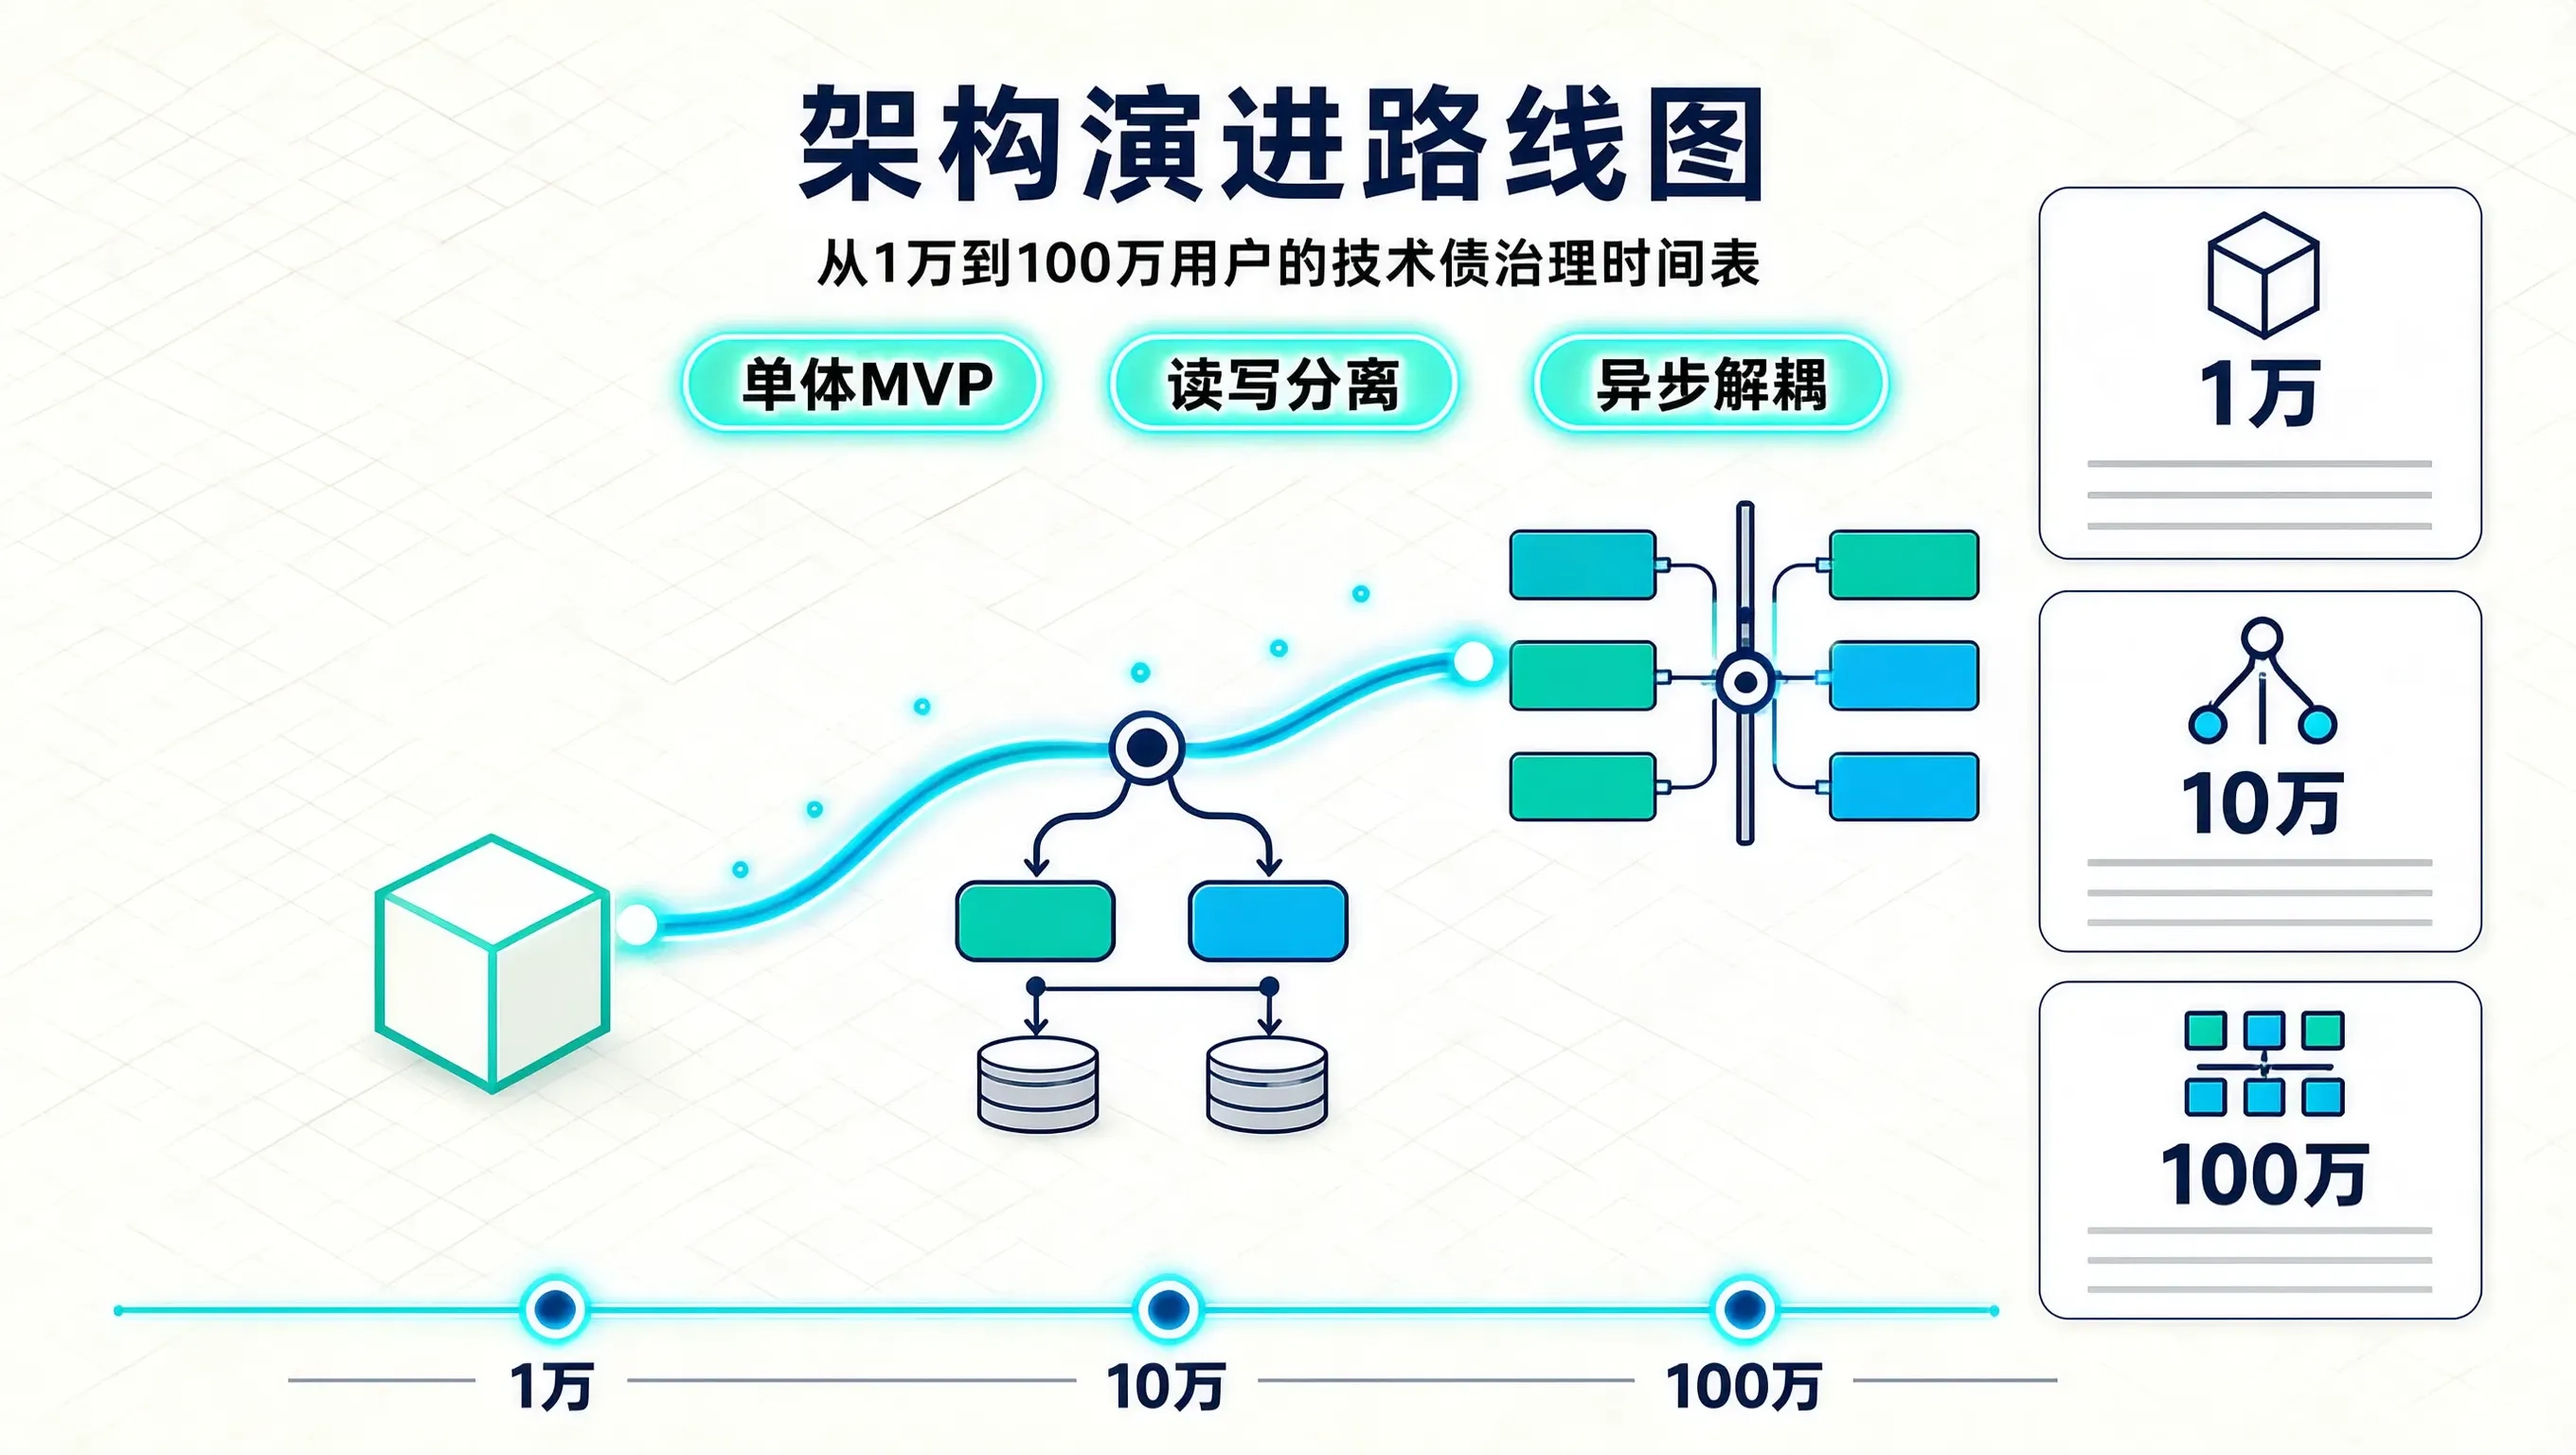
做技术创业最忌讳两件事:一是一上来就照着大厂百万 QPS 的架构做过度设计,把公司活活拖死在上线前;二是完全不留演进空间,任由代码腐化,结果在用户量爆发时系统瞬间崩盘。
从操作系统开发者转做科技产品并创办公司,我经历过系统从日活几百人到数十万用户的完整生命周期。技术架构不是一蹴而就的艺术品,而是一份动态还债的资产负债表。在不同的用户量级,团队必须对技术债务有清醒的容忍线与清偿节奏。
今天我把团队从 1 万用户跑通到 100 万用户过程中的技术债演进路线图与治理时间表做一次系统拆解。
一、第一阶段:1 万用户(MVP 验证期)——用单体与托管换取极致速度
在验证产品市场契合度(PMF)的初期,团队的核心目标是“活下来并测出留存率”。此时任何高可用集群和分库分表都是严重的资源浪费。
1. 架构基准形态
- 计算层:单体应用服务(Go / Node / Python),单实例运行在 2 核 4G 的云主机上,通过 systemd 保活;
- 存储层:单节点云托管 PostgreSQL / MySQL,开启每日自动快照;
- 缓存与异步:单节点 Redis 实例,承载会话缓存与极简的任务队列。
2. 允许欠下的技术债
- 模块间直接在进程内做内存调用,不定义复杂的 RPC 契约;
- 数据表缺少严格的归一化,允许包含少量冗余字段与 JSON 格式配置;
- 缺少自动化测试用例,主要依赖核心业务链路的 Smoke Test。
3. 必须守住的底线
- 唯一自增/雪花 ID 规范:主键严禁使用自增整型外露给前端,避免后续业务拆分时 ID 冲突;
- 核心数据变更有审计日志:资金、权限、关键状态流转必须记录操作流水;
- 数据库连接池参数调优:防止单机连接数耗尽直接拖垮单体。
二、第二阶段:10 万用户(规模化起步期)——无状态化与读写分离
当用户量突破 10 万,单机 CPU 和内存瓶颈开始显现,偶发的慢查询会导致整个应用失去响应。此时必须启动第一轮系统化重构。
                    ┌─────────────────────────┐
                    │      云负载均衡 (SLB)     │
                    └────────────┬────────────┘
                                 │ 轮询 / 权重
                   ┌─────────────┴─────────────┐
                   ▼                           ▼
        ┌─────────────────────┐     ┌─────────────────────┐
        │  无状态应用节点 A     │     │  无状态应用节点 B     │
        └──────────┬──────────┘     └──────────┬──────────┘
                   │ 读写请求                  │ 读写请求
        ┌──────────┴──────────┬────────────────┴──────────┐
        ▼                     ▼                           ▼
┌──────────────┐     ┌─────────────────┐         ┌─────────────────┐
│ Redis 哨兵集群 │     │  MySQL 主库 (写) │ ──复制──> │  MySQL 从库 (读) │
└──────────────┘     └─────────────────┘         └─────────────────┘
1. 核心改造动作
- 服务无状态化(Stateless):将所有存储在本地内存的 Session、临时上传文件全部剥离至 Redis 与对象存储(OSS/S3),实现应用实例的水平横向伸缩(Scale-Out);
- 数据库读写分离:业务查询流量通常占 80% 以上。引入主从复制架构,写走主库,重度报表和列表查询走只读副本;
- 引入本地二级缓存:利用 Go
bigcache或 Java Caffeine 拦截超高频的静态元数据请求,减轻 Redis 集中式网络压力。
2. 治理时间表与工时配比
- 每周固定抽出 20% 的工程工时(每周五全天) 专门处理 Sentry 告警中的前 5 名慢 SQL 与接口异常;
- 引入慢查询阻断机制:单次查询超过 200ms 的 SQL 必须强制建立组合索引或重写。
三、第三阶段:100 万用户(高并发与多业务线期)——模块解耦与异步化
进入百万用户阶段,单表数据量迅速突破千万级,跨部门协作导致代码冲突剧烈。此时的重点不是盲目上微服务,而是基于领域的模块解耦与强一致性异步化。
1. 架构演进策略矩阵
| 架构维度 | 演进前现状 | 百万用户治理方案 | 还债代价评估 |
|---|---|---|---|
| 核心业务通信 | 同步 HTTP 阻塞调用 | 引入 Kafka/RabbitMQ 事件驱动 | 需处理消息幂等与死信重试 |
| 关系型单表膨胀 | 订单表超 3000 万行,DDL 锁表 | 按时间冷热归档 + 按用户 ID Hash 分表 | 需重构跨分片查询逻辑 |
| 搜索与聚合统计 | MySQL LIKE 模糊查询 | 同步至 Elasticsearch/OpenSearch 引擎 | 需维护双写与数据同步延迟 |
| 接口故障蔓延 | 单模块故障导致全站不可用 | 引入 Sentinel/Hystrix 做熔断与降级 | 需在前端配合设计兜底 UI |
// 典型的高并发幂等消费落地代码范式
package consumer

import (
    "context"
    "database/sql"
    "fmt"
)

type EventConsumer struct {
    db *sql.DB
}

func (c *EventConsumer) ProcessOrderCreated(ctx context.Context, eventID string, orderID string) error {
    tx, err := c.db.BeginTx(ctx, nil)
    if err != nil {
        return err
    }
    defer tx.Rollback()

    // 1. 利用数据库唯一索引或防重表实现强幂等消费
    _, err = tx.ExecContext(ctx, "INSERT INTO processed_events (event_id) VALUES (?)", eventID)
    if err != nil {
        // 捕获唯一键冲突,说明事件已被消费,直接返回成功以 ACK 消息
        return nil
    }

    // 2. 执行真正的业务扣减或状态更新
    _, err = tx.ExecContext(ctx, "UPDATE orders SET status = 'PAID' WHERE order_id = ?", orderID)
    if err != nil {
        return fmt.Errorf("update order error: %w", err)
    }

    return tx.Commit()
}
四、技术债治理的经营哲学
在创业团队做架构,我有一套铁律:“不要在没有问题的地方提前解决问题,但绝对不能在已经亮黄灯的地方视而不见。”
- 红线指标预警:当数据库 CPU 利用率持续超过 60%,或连接数占用率达到 70% 时,必须在当周 Sprint 强行插入重构排期;
- 业务与技术的汇率折算:向业务方申请重构资源时,永远不要讲“代码设计不优雅”,而要讲“这次改造能让支付接口的吞吐量提升 3 倍,支撑国庆大促且服务器账单降低 40%”。
把架构演进当成公司资产的精细化运营,你才能在狂奔的业务与脆弱的系统之间,筑起坚不可摧的技术防线。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 3
 0
- 0


 已为社区贡献71条内容

所有评论(0)