操作系统底层机制对现代分布式架构的映射:调度、缓存与通信的底层同构性
操作系统底层机制对现代分布式架构的映射:调度、缓存与通信的底层同构性
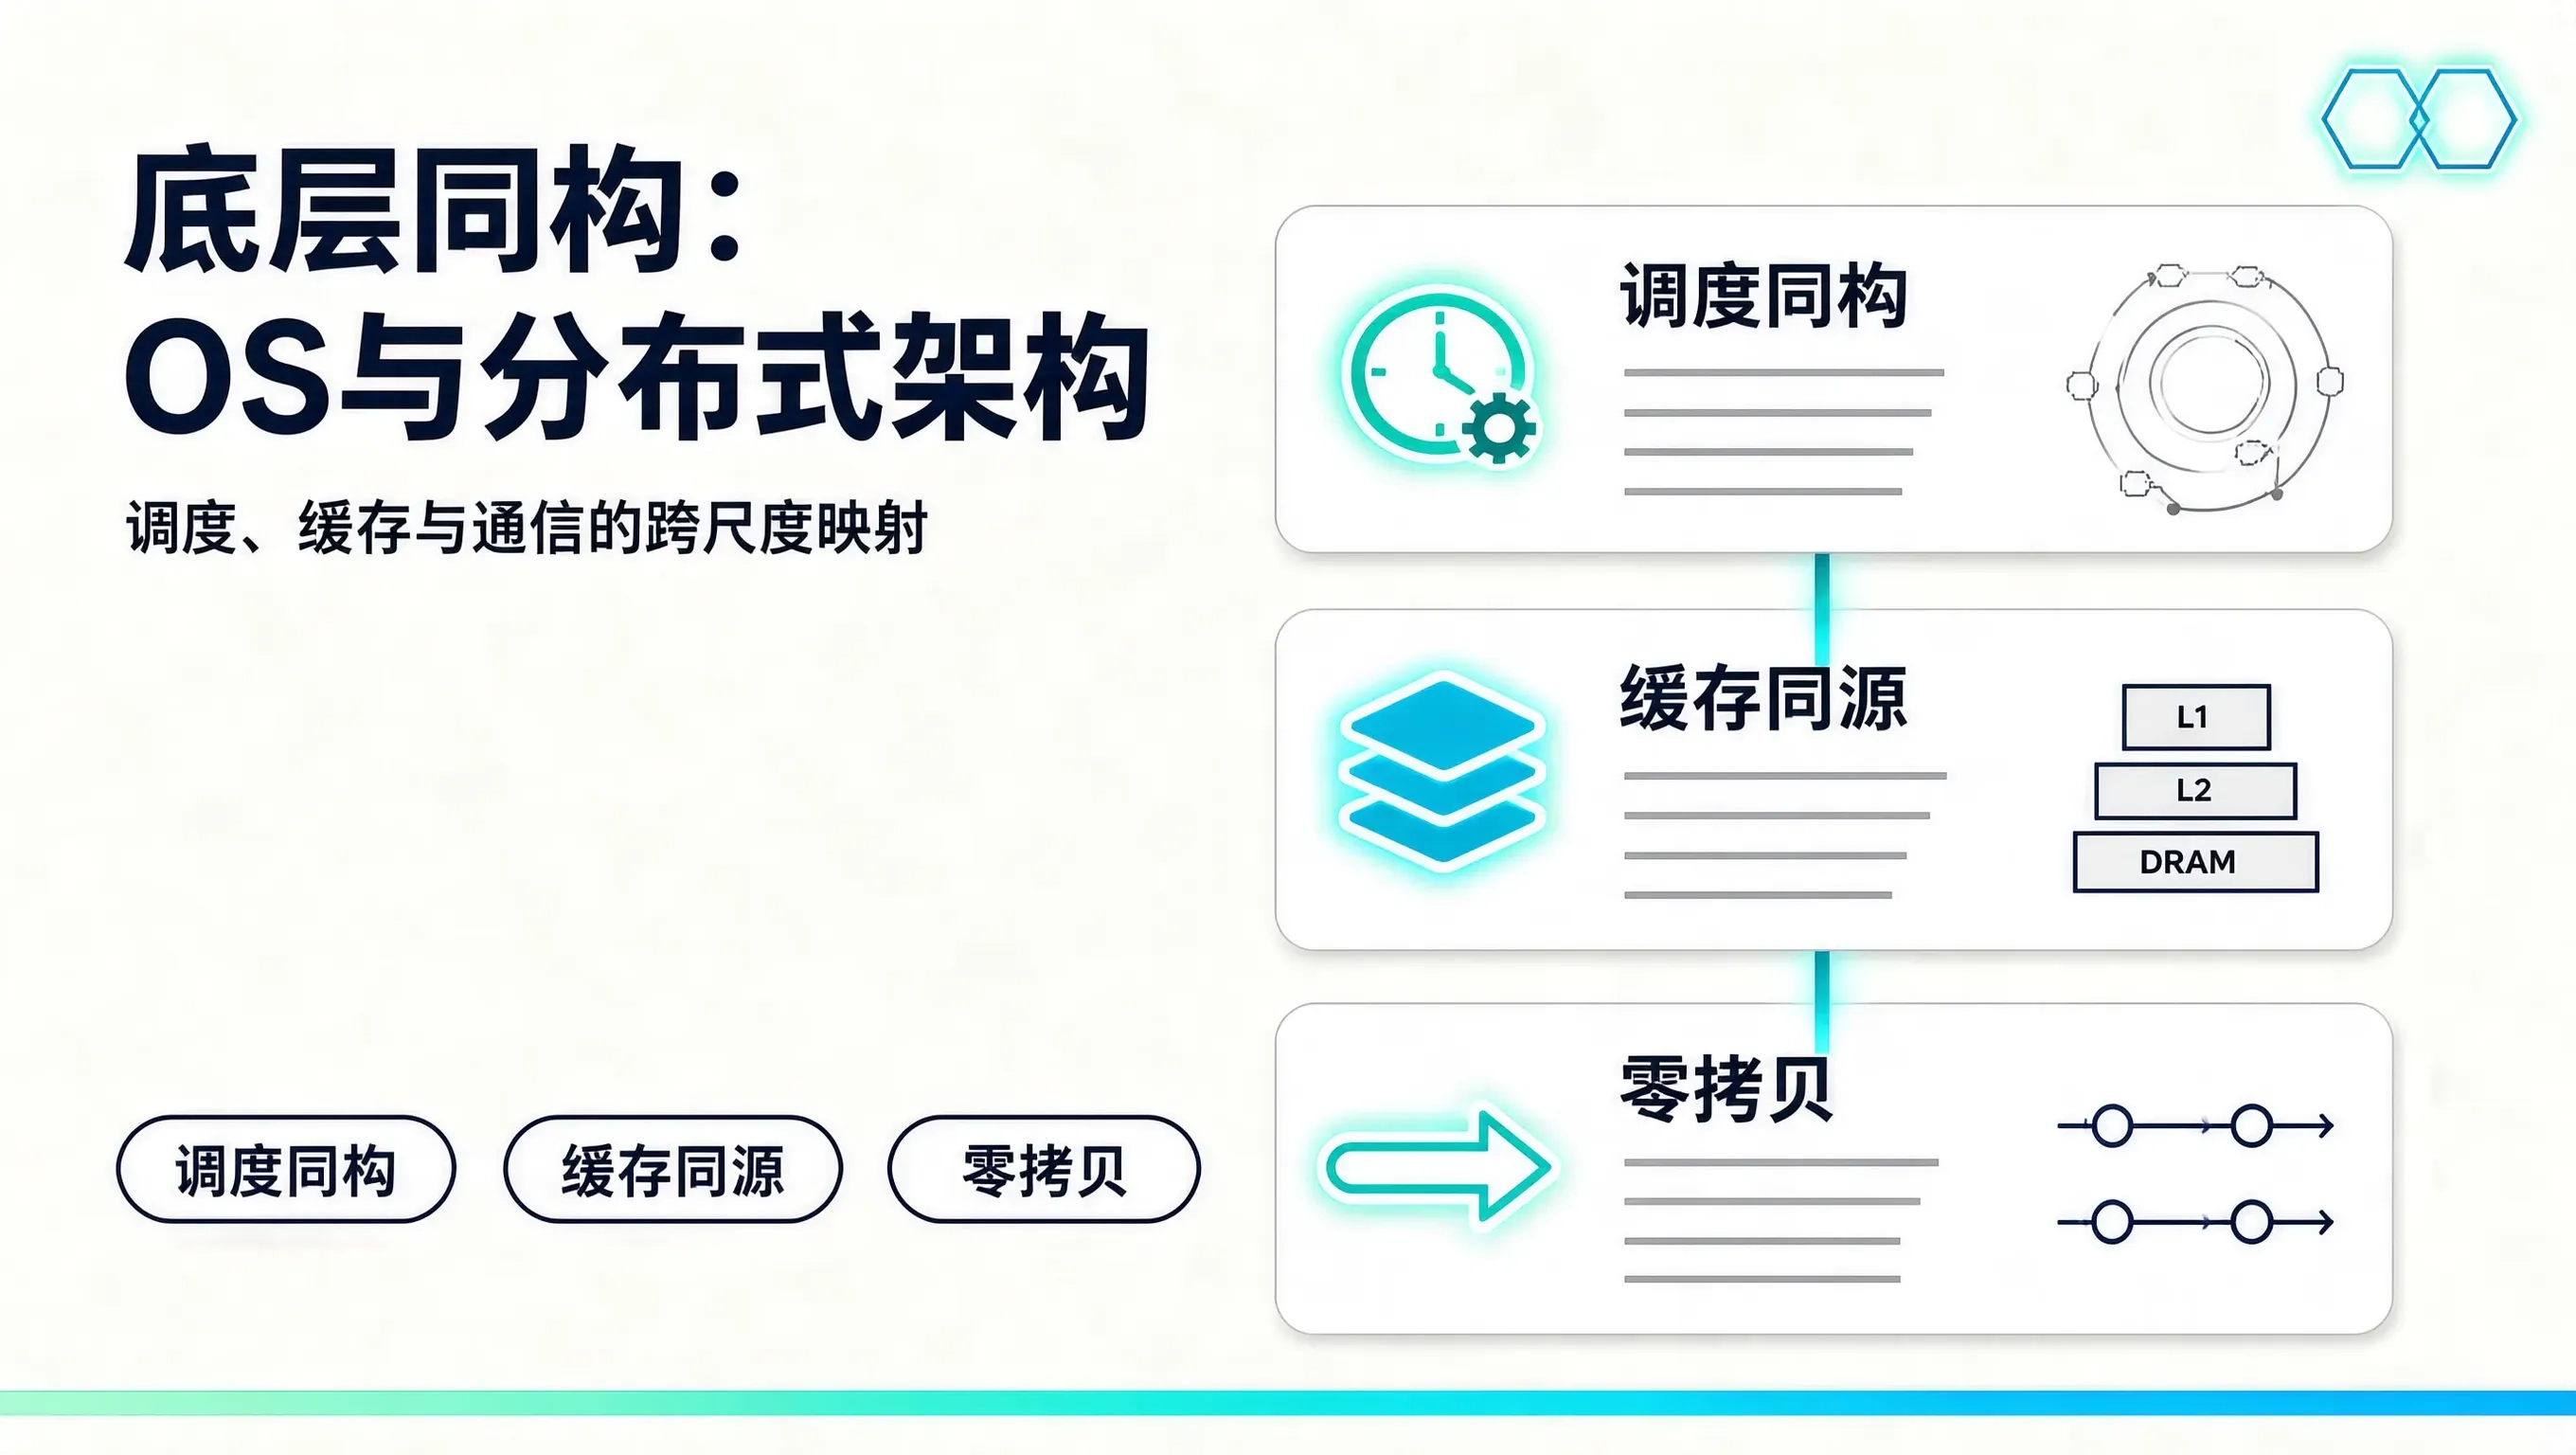
做嵌入式和 Linux 内核开发的前几年,我总觉得分布式系统是另一套完全不同的技术世界:CAP 定理、Raft 共识、微服务网关、分布式缓存。直到后来带团队做分布式后端架构,又转做科技产品,我才猛然意识到:计算机科学发展了半个世纪,真正底层解决“资源分配、并发协作与通信损耗”的核心模型几乎从未改变。
现代分布式系统的几乎每一个经典设计模式,都能在 Linux 内核与单机操作系统中找到 1:1 的底层同构原型。理解这种同构性,不仅能帮工程师在面对微服务性能瓶颈时一眼看穿本质,也能在架构选型时少交数十万的技术学费。
一、进程调度 vs 分布式资源调度:从 CFS/EEVDF 到 K8s 调度器
在单机 Linux 内核中,CFS(完全公平调度器)与 6.6 引入的 EEVDF 解决的是:如何在多个线程之间,按照权重(nice 值)和虚拟运行时间(vruntime / lag)公平且低延迟地分配有限的 CPU 时间片。
而在分布式集群中,Kubernetes 的 kube-scheduler 或 YARN 调度器,面对的是同样的问题,只是调度的粒度从“时间片”变成了“节点 Pod 槽位与内存配额”。
| 调度维度 | 单机 Linux 内核机制 | 分布式 Kubernetes 机制 |
|---|---|---|
| 优先级与权重 | nice 值(-20 到 19)与 static_prio | PriorityClass 与 Resource Request/Limit |
| 亲和性与拓扑感知 | sched_domain / NUMA 节点绑定 | nodeAffinity / podTopologySpreadConstraints |
| 抢占机制 | resched_curr 触发中断抢占 | 高优先级 Pod 触发低优先级 Pod Eviction |
| 负载均衡 | CFS 的 load_balance 跨 CPU 迁移 | Descheduler 跨 Node 重新调度与平衡 |
在内核中,跨 NUMA 节点的内存访问会导致 2~3 倍的延迟开销,因此内核调度器有极强的“局部性保护”;同理,在跨可用区(Cross-AZ)的 K8s 集群中,如果不配置拓扑分布约束,Pod 跨机房调用的网络延迟和公网流出账单,本质上就是分布式系统里的“NUMA 颠簸”。
二、内存缓存体系 vs 分布式缓存:Page Cache 与 Redis 的治理同源性
单机 OS 中最核心的缓存是 Page Cache(页缓存),它位于 VFS 与底层物理块设备之间;分布式架构中我们用 Redis/Memcached 挡在应用与 MySQL 之间。两者的核心矛盾和解决策略完全同源:
- 写策略的一致性权衡:
- Linux Page Cache 默认采用 Write-Back(写回) 机制,数据写入内存即返回成功,后台由
writeback线程异步刷盘。这种机制吞吐量极高,但遇到断电会丢失未刷盘的脏页。 - 分布式系统中,我们为了抗住高并发写,常使用 Redis 做暂存再通过 MQ 异步落库(Write-Back),同样需要面对 Redis 宕机时的数据补偿。
- Linux Page Cache 默认采用 Write-Back(写回) 机制,数据写入内存即返回成功,后台由
- 内存水位与淘汰算法:
- Linux 内核维护 Active 和 Inactive 两个 LRU 链表,当内存低于
min_free_kbytes时触发kswapd异步回收,低于极端水位时触发同步回收(Direct Reclaim)导致进程卡顿。 - Redis 的
maxmemory-policy: allkeys-lru采用近似 LRU 采样算法,内存耗尽时拒绝写入或触发淘汰。
- Linux 内核维护 Active 和 Inactive 两个 LRU 链表,当内存低于
// Linux 内核中判断页面是否可以释放的典型逻辑抽象
// 类似于分布式缓存中的热点探测与防抖
static inline bool is_page_hot(struct page *page) {
    // 如果页面最近有被访问的引用计数(PG_referenced)
    if (TestClearPageReferenced(page)) {
        return true; // 依然是热点,保留在活跃链表
    }
    return false; // 降级到非活跃链表,等待下一次回收
}
如果你在单机上理解了为什么大量脏页回写会导致磁盘 I/O 阻塞(I/O Hang),你就能瞬间想通为什么 Redis 集中过期或 BigKey 序列化会导致分布式网关的 P99 延迟暴增。
三、IPC 进程间通信 vs RPC 分布式通信:从零拷贝到传输协议
在操作系统内部,不同进程间传递数据的方式决定了系统的吞吐极限;分布式系统中,微服务间的通信更是决定了调用链的延迟拓扑。
【单机 IPC 演进】
管道/Socket (多次内核拷贝) ──> 共享内存 shm / mmap (零拷贝) ──> 信号/事件驱动 (epoll)

【分布式 RPC 演进】
HTTP/1.1 REST (文本协议/频繁建连) ──> gRPC / Protobuf (二进制/多路复用) ──> RDMA / eBPF (内核旁路)
- 数据拷贝的开销认知:
单机 Linux 从磁盘读取文件发送到网卡,传统read + write需要 4 次上下文切换和 4 次数据拷贝;使用sendfile系统调用可以做到零用户态拷贝。
在分布式微服务中,一个 10MB 的 JSON 报文在网关解析、序列化、反序列化、再转发给内部 RPC 服务,所浪费的 CPU 周期与内存带宽,完全是在重演单机早期“多次内存搬运”的低效历史。这正是为什么高性能微服务必须推行 Protobuf/FlatBuffers 和连接复用。 - 阻塞与多路复用:
单机网络从select/poll演进到epoll的红黑树与就绪链表;现代分布式网关(如 Envoy、Nginx)的核心事件循环,直接建立在 Linuxepoll之上。
四、技术人认知升维:在底层规律中寻找架构确定性
很多年轻工程师经常陷入框架疲劳:今天学习 Spring Cloud,明天研究 K8s Service Mesh,后天探索 Dapr。各种名词层出不穷,越学越觉得技术栈庞杂无边。
但我常跟团队里的同学讲:框架会随业务浪潮快速更迭,但计算机体系结构的物理限制永远不变。
- 光速决定了跨机房延迟永远大于同机架通信;
- 硅芯片的内存层次结构(L1/L2/L3 -> DRAM -> NVMe -> Network)决定了缓存与分层存储的永恒必要性;
- 并发的本质永远是竞争状态与锁开销的博弈。
当你用 Linux 内核的调度器、虚拟内存管理、VFS 和中断处理的视角,去重新审视分布式网关、分库分表、流计算引擎与服务网格时,你会发现所有的技术选型不再神秘。它们不过是在更大的物理尺度上,重新实现了一遍操作系统早已写好的教科书。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献76条内容

所有评论(0)