【Linux-System】【ELF加载揭秘:从磁盘到CPU的硬核旅程】流食般投喂
📝 博客写手专家
ELF程序加载与动态链接原理:从磁盘上的“0地址”到CPU取指执行的全链路拆解
——一堂把编译原理、文件系统、内存管理、进程加载串成线的硬核课
引言:为什么你写的C代码跑起来,远比“编译-运行”四个字复杂得多?
很多初学者以为,程序的生命周期不过是 gcc hello.c -o hello 然后 ./hello。但这堂课会把这一过程彻底拆开:你的代码是如何在磁盘上拥有“地址”的?可执行文件凭什么不是简单的“代码+数据”堆在一起?操作系统怎么知道该把哪段加载到哪里?动态库凭什么能被“共享”?以及,为什么你敲下的 main 函数,根本不是程序运行的真正起点?
这篇文章将基于课堂实录与板书,完整梳理从源码到进程、从静态链接到动态共享的每一个关键节点。我们会保留课堂上所有的实战命令(readelf、objdump、ldd)、经典示例(hello.c + code.c 链接实验)和那些容易被忽略的“零碎知识点”——包括为什么 .bss 段 Better Save Space,为什么内存管理的基本单位 4KB 决定了 Section 合并成 Segment 的必然性,以及 _start 函数在调用你的 main 之前到底偷偷干了多少脏活累活。
一、ELF文件格式:可执行程序不是“代码+数据”那么简单
1.1 四大组成部分与“双重视角”
一个 ELF(Executable and Linkable Format)可执行程序由四大块构成:
- ELF Header:文件的“户口本”,记录整个文件的管理信息。
- Program Header Table:给操作系统加载器看的“配送单”,描述哪些 Section 该合并成 Segment,以及加载到内存时的权限(读/写/执行)。
- Section Header Table:给编译器和链接器看的“施工图”,描述
.text、.data、.bss等每个数据节的属性、偏移量和大小。 - 数据节(Section):真正存放代码、数据、符号表等内容的地方。
📌下面是ELF文件格式预览图: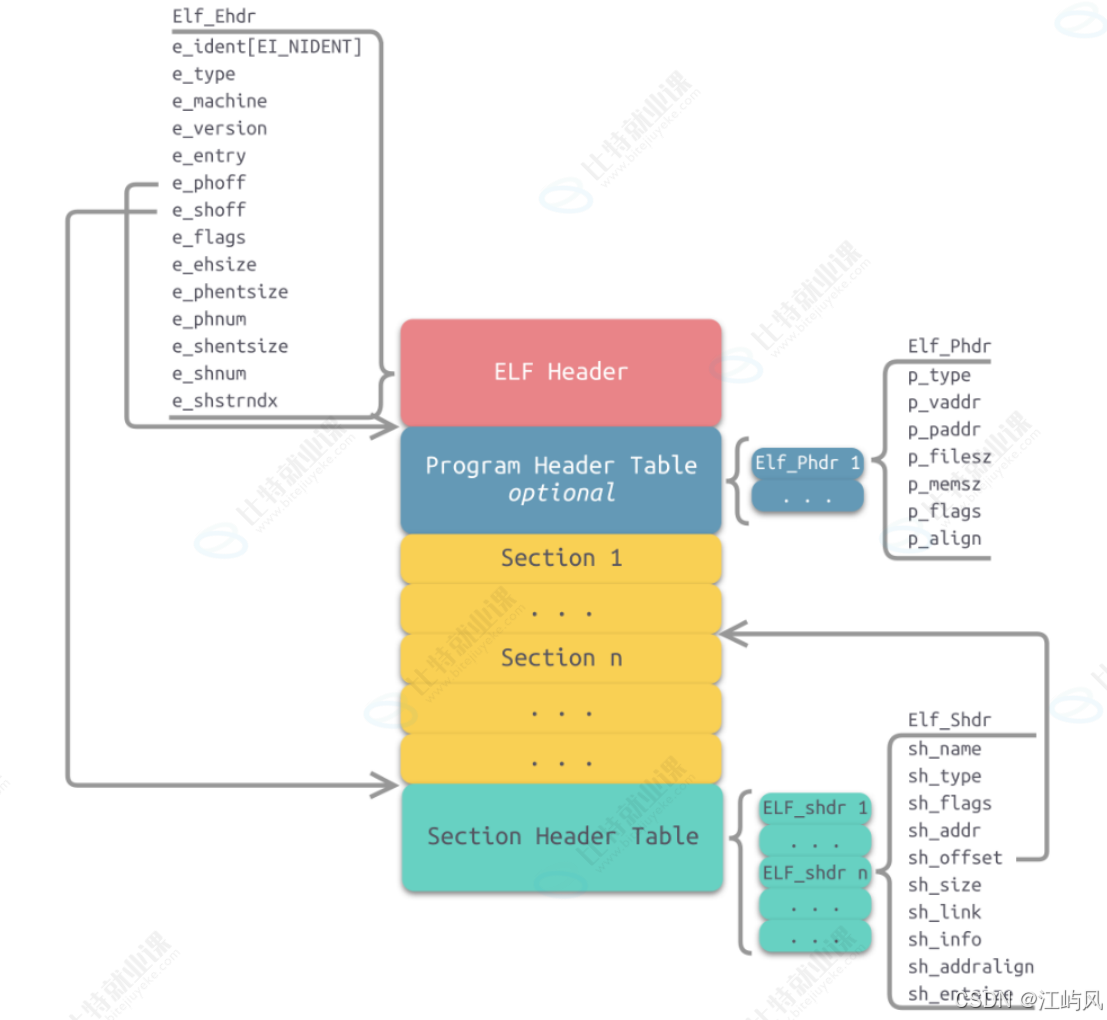
这里有一个贯穿全文的核心思想:ELF 文件存在两个视角。
- 编译与链接视角:关心 Section Header Table。链接器把多个
.o文件的 Section 合并,形成最终的可执行文件。 - 执行与加载视角:关心 Program Header Table。操作系统不关心你有 30 个 Section,它只关心该把哪些东西打包成几个 Segment 塞进内存。
1.2 Section 与 Segment:为什么要“合并”?
课堂上老师用 readelf -S /usr/bin/ls 做了一个现场实验。输出显示 ls 命令足足有 30 个 Section(从 0 编号到 29)。但操作系统能直接把这 30 个小碎块分别加载进内存吗?
不能。因为内存管理的基本单位是 4KB(一页)。 磁盘与内存进行 I/O 交互时,基本单位也是 4KB。如果一个 .text 只有 1KB、一个 .rodata 只有 512 字节,各自独占一页,内存会迅速被碎片撑爆。老师举了一个精确的例子:
假设代码段实际占
4097字节,只读数据占512字节。如果不合并,代码段要占两页(4096+1 各一页),只读数据独占一页,总共 3 页。但如果把.text和.rodata合并成一个 Segment,总共4609字节,只需 2 页 即可装下。
这就是 Section 合并为 Segment 的根本原因:减少页面碎片,提高内存利用率,同时基于权限实现访问控制(代码只读、数据可写、堆栈可执行等权限控制)。
用 readelf -l /usr/bin/ls 验证,原本的 30 个 Section 被合并成了 9 个 Program Header(Segment)。输出中的 Section to Segment mapping 清晰显示了 .text、.rodata 合并为只读可执行的代码段,.data、.bss 合并为可读写的数据段。
1.3 BSS 段:Better Save Space
课堂上对 .bss 的讲解非常生动。全局变量分两种:已初始化和未初始化。已初始化的必须记录具体值(如 int a = 10),存在 .data。但未初始化的(如 int b;),默认值全是 0。
如果定义了 50 个未初始化的
int,难道要在磁盘上记录 50 个0吗?没必要。.bss在磁盘上只记录一个总大小(比如50),加载到内存时再一次性开辟 50×4=200 字节并清零。
.bss 的全称被老师戏称为 Better Save Space——它节省的是磁盘空间。加载时才真正展开并初始化清零,这也是为什么未初始化全局变量天生为 0 的底层机制。
1.4 ELF Header 的 Magic 与入口地址
用 readelf -h 读取 /usr/bin/ls,你会看到:
-
Magic:文件开头一串固定魔数(如
7f 45 4c 46),操作系统靠它判断“这货是不是 ELF”。几乎所有二进制格式(图片、音乐、视频)开头都有 Magic,类似于文件的“身份证”。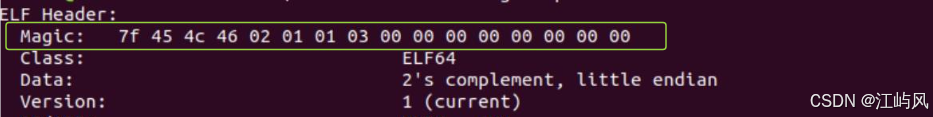
-
Entry point address:程序的入口地址。对于
ls,它是一个类似0x401430的虚拟地址。这个地址指向的不是你的main函数,而是 _start。后文会详细展开。
下面是 ELF 文件的双重视角与 Section 合并为 Segment 的示意图:
图解: 磁盘上的 30 个 Section 通过两个视角被处理——链接器按 Section 合并,操作系统按 Segment 加载,最终在内存中形成只读的代码段与可读写的数据段。
二、静态链接:符号解析与地址重定位
静态链接的本质,是把多个 .o 文件和静态库“糊”成一个独立的可执行文件。课上用 hello.c 和 code.c 做了一个极简但足够说明问题的实验。
2.1 实验环境:两个 C 文件,三个编译阶段
/* hello.c */
int run();  /* 声明外部函数 */
int main() {
    printf("hello");
    run();
    return 0;
}

/* code.c */
int run() {
    printf("run func");
    return 0;
}
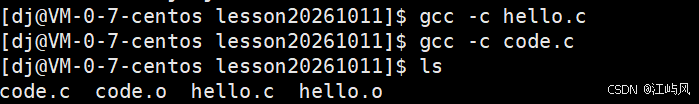
编译为 .o:
gcc -c hello.c -o hello.o
gcc -c code.c -o code.o
2.2 符号表:Defined vs Undefined
用 readelf -s hello.o 查看符号表:
-
main、printf(实际底层是_fputs等)在hello.o中标记为 UND(Undefined)——我不知道它们在哪。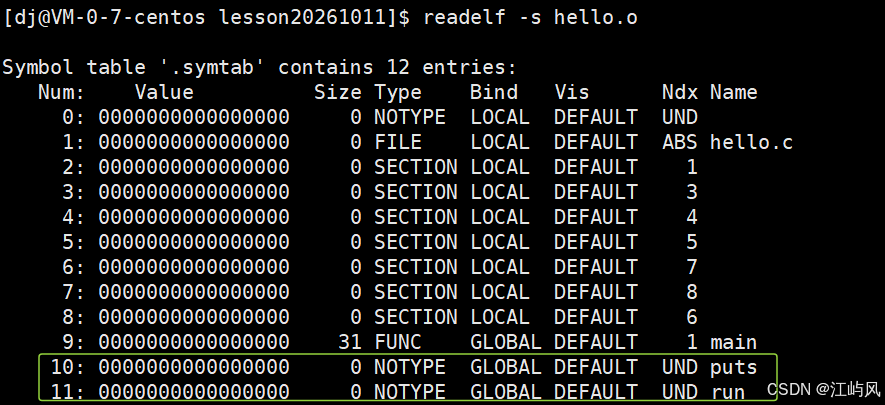
-
run同样标记为 UND,因为hello.c里没有它的定义。
而在 code.o 中,run 被标记为 FUNC 且已定义。链接器的核心工作就是:拿着自己未定义的符号,去其他模块找定义。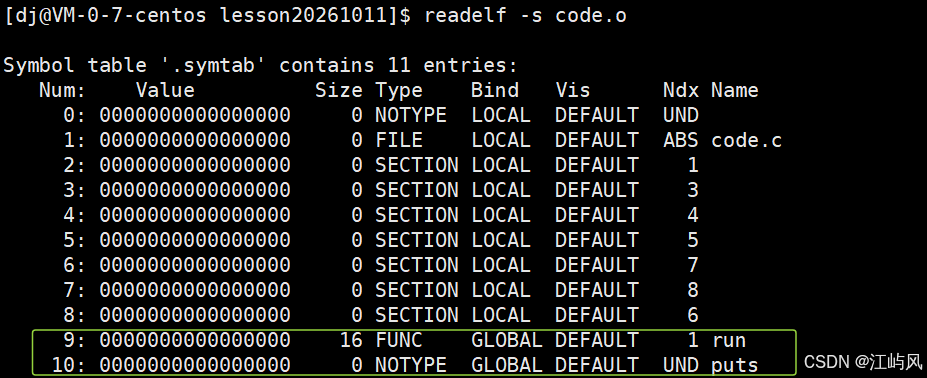
2.3 地址重定位:call 后面为什么先是 0?
用 objdump -d hello.o 反汇编,查看 main 函数里的调用:
call   0  <?printf>
call   0  <run>
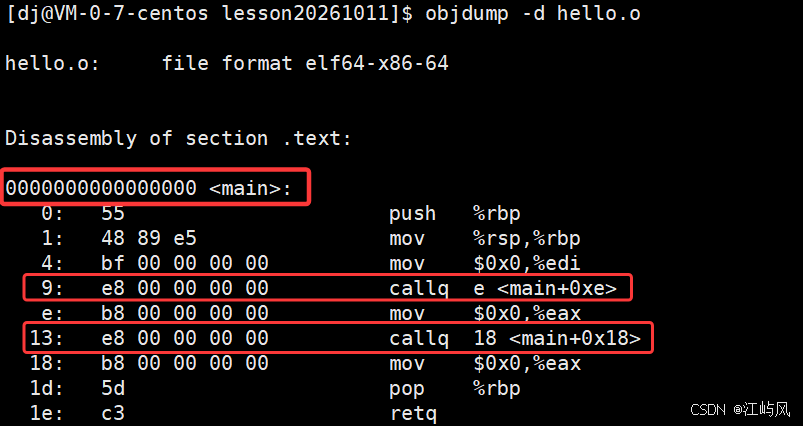
老师强调:编译阶段根本不知道 printf 和 run 在内存的哪个位置,所以编译器只能把跳转地址暂时填成 0。这个 0 是一个占位符。
当执行链接:
gcc hello.o code.o -o main.exe
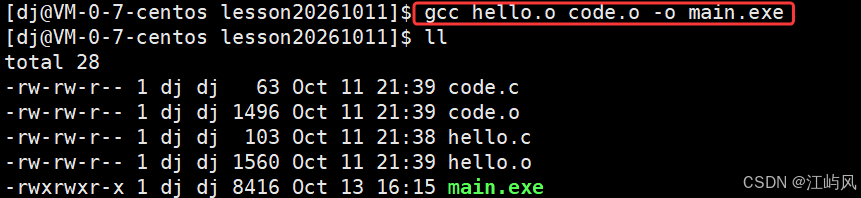
链接器完成两件事:
- 合并 Section:把
hello.o和code.o的.text合并成一个大.text,.data合并成一个大.data。 - 地址重定位:确定每个函数在最终可执行文件中的虚拟地址(比如
run被安排在了0x400520),然后把所有call 0修正为call 0x400520。
链接后再 objdump -d main.exe,你会看到 call 指令后面的地址已经被填上了真实的虚拟地址。这个过程就叫“链接时地址重定位”。
也正因 .o 文件里的地址在链接时会被“重新修改”,.o 被称为可重定位目标文件(Relocatable Object File)。
下面是静态链接中符号解析与地址重定位的完整流程:
图解: 编译阶段 call 后的地址是占位符 0;链接阶段完成 Section 合并、符号解析与地址重定位,最终把真实虚拟地址填入 call 指令。
三、程序加载与虚拟地址空间:程序没有加载前,有地址吗?
这是课堂上抛出的一个核心思考题,也是很多操作系统的“分水岭”知识点。
3.1 有!磁盘上的逻辑地址,就是虚拟地址的“预览版”
用 objdump -s 反汇编任何一个可执行程序(如 main.exe),最左侧会看到一连串地址:0x4003c8、0x4003d0、0x4003f0……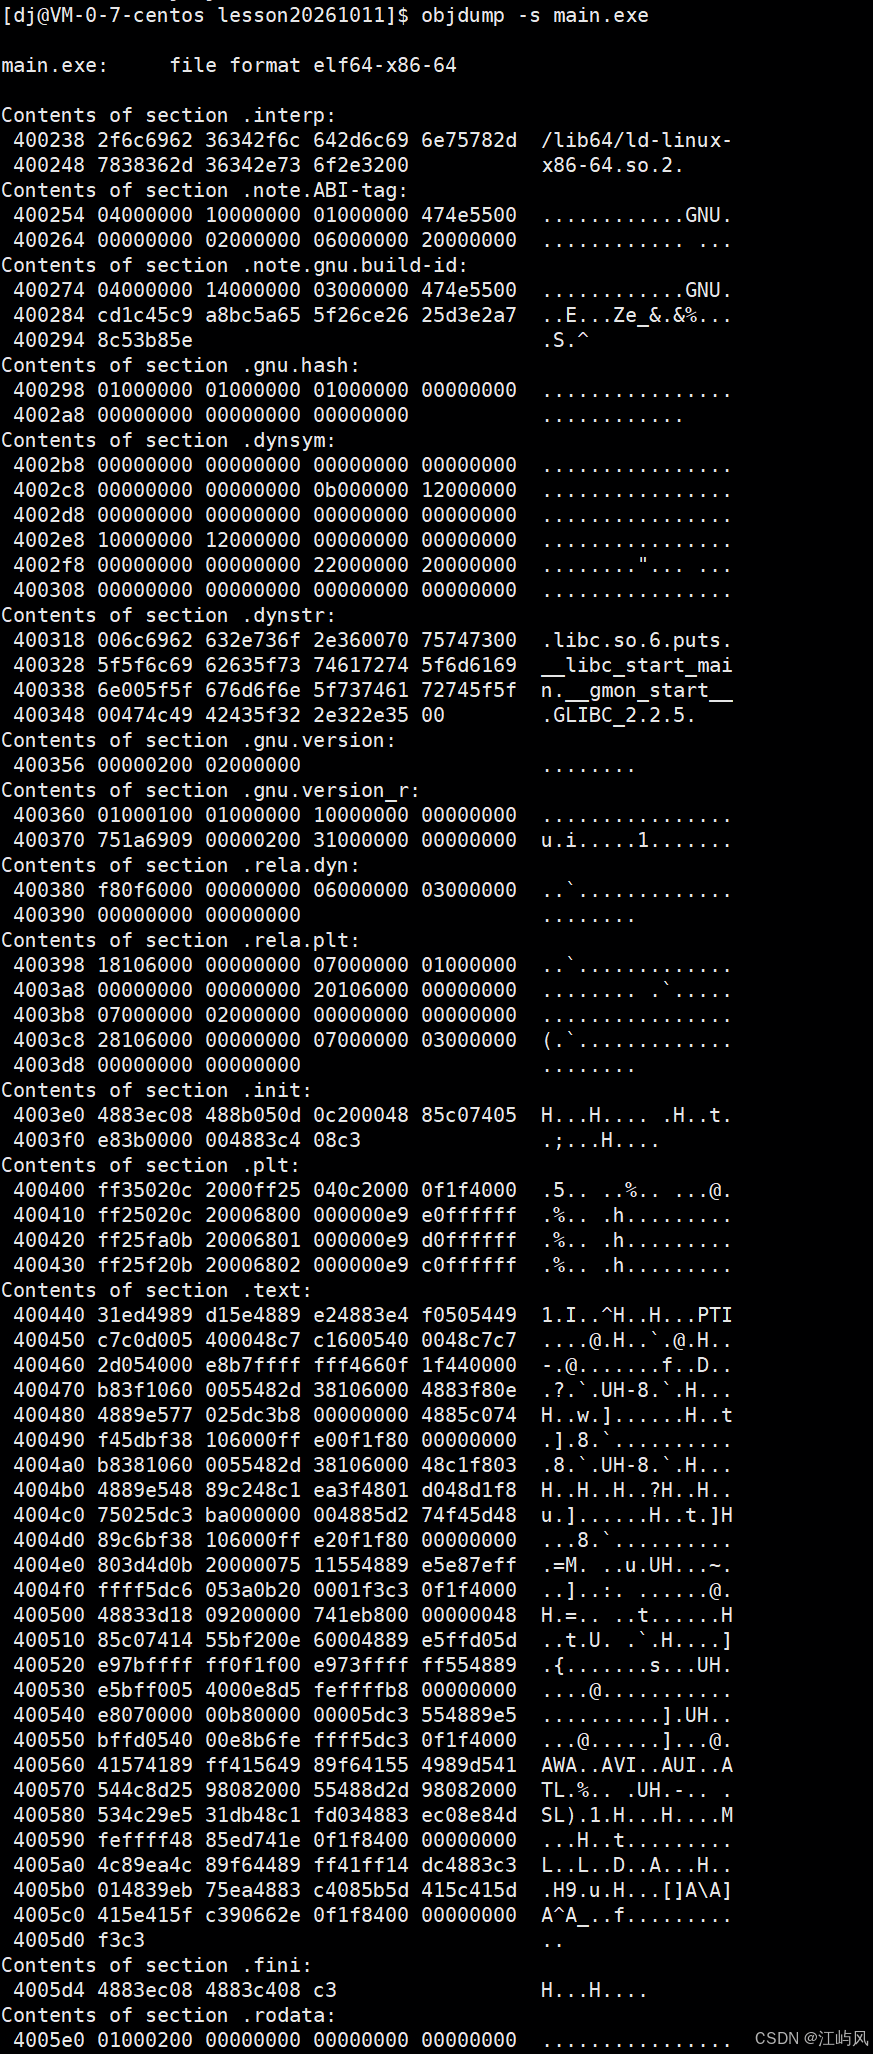
这些地址是什么?它们是程序在磁盘上就已经确定的编制。现代操作系统采用 平坦模式(Flat Model),即可执行程序内部从 0 开始统一编址。这个磁盘上的地址称为逻辑地址或线性地址。
在 Linux 系统下,逻辑地址(磁盘视角)、虚拟地址(操作系统视角)、物理地址(真实内存视角)三位一体。只是在磁盘上我们习惯叫逻辑地址,加载到内存语境后(在PCB等那边),它们就是虚拟地址。程序还没加载时,内部函数调用的地址就已经编好了——否则链接器凭什么重写 call 指令?
3.2 加载四步曲:从文件系统到 CPU 取指
老师用一张大图把加载流程串了起来:
第一步:文件系统定位
操作系统通过路径解析找到 inode,进而找到磁盘上的数据块(Data Block)。可执行程序本质上也是文件,也要走文件系统这一套。
第二步:创建进程骨架
内核创建 task_struct(PCB)、mm_struct(内存描述符)、vm_area_struct 链表(虚拟内存区域)。此时进程有了“户口”,但地址空间还是空的。
第三步:初始化地址空间与页表映射
操作系统读取 ELF 的 Program Header Table,用每个 Segment 的虚拟起止地址(start ~ end)去初始化 vm_area_struct 的各个区域(代码区、数据区、BSS 区等)。随后把代码和数据加载到物理内存,建立页表映射——页表左半边是虚拟地址,右半边是物理地址。
第四步:CPU 启动执行
读取 ELF Header 中的 Entry Point(即 _start 的虚拟地址,如 0x400430),把它填入 CPU 的指令寄存器(EIP/RIP)。CPU 开始取指执行。
3.3 权限管理与页表初始化
操作系统并不“认识”哪个区域是代码、哪个是数据,它只读 ELF 的 Program Header。如果某个 Segment 标记为 R E(只读、可执行),操作系统初始化页表时就把这段映射为只读;如果标记为 RW,则赋予读写权限。程序的权限管理,在加载那一刻就由 ELF 格式决定了。
3.4 一个极易忽略的细节:_start 才是入口
很多同学以为程序入口是 main。但通过 objdump 和 readelf -h 都能看到,Entry Point 指向的是 _start。_start 由链接器(或 C 运行时库)提供,它的职责包括:
- 设置栈帧;
- 初始化
.data段(把初始化的全局变量搬到位); - 清零
.bss段; - 打开标准输入、标准输出、标准错误;
- 调用动态链接器,加载依赖的动态库;
- 最后调用
libc_start_main,进而调用用户写的main。
你的 main 函数执行完毕后,控制权回到 _start 的收尾逻辑,处理返回值并调用 exit 终止进程。main 只是“被调用者”。
下面是程序加载四步曲的完整流程,从文件系统定位到 CPU 取指执行:
图解: 操作系统先通过文件系统定位 ELF,创建进程骨架,再按 Program Header 初始化地址空间与页表,最后把 _start 的虚拟地址填入 CPU 指令寄存器开始执行。
四、动态链接与共享库:GOT/PLT 与延迟绑定
静态链接虽然简单,但有个致命缺陷:每个可执行文件都独立拷贝一份库代码。如果系统里运行着 20 个 C 程序,内存里就有 20 份 printf 的代码,浪费磁盘和内存。动态链接(Dynamic Linking)解决了这个问题。
4.1 动态库的宏观共享机制
动态库(.so,Shared Object)是独立文件。当进程 A 加载 libc.so 后,它通过页表映射到自己的共享区。如果进程 B 也需要 libc.so,内核只需把同一份物理内存映射到 B 的虚拟地址空间。代码段是只读的,所以多进程可以安全共享同一份物理副本。这也是为什么动态库又叫共享库。
4.2 动态链接器(ld-linux.so)
任何一个动态链接的 ELF 程序,除了依赖 C 标准库,还会默认依赖一个库:/lib64/ld-linux-x86-64.so.2(或类似名称)。这就是动态链接器。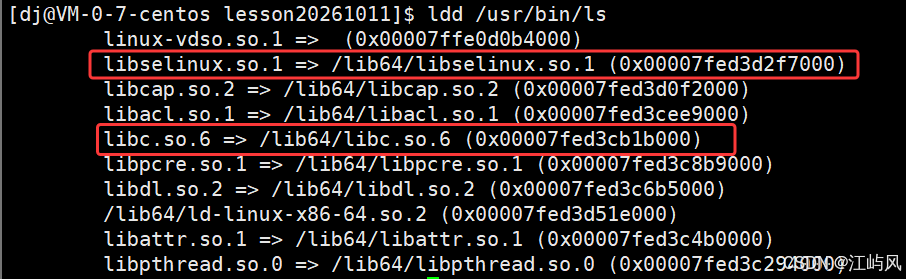
程序启动时,_start 会先调用它。动态链接器根据环境变量 LD_LIBRARY_PATH、/etc/ld.so.conf 配置文件以及系统默认路径,去搜索并加载程序依赖的所有 .so。只有当这些库都被找到、映射、重定位完毕后,才会把控制权交回给 main。
4.3 位置无关代码(PIC)与 GOT
动态库可以被加载到内存的任意位置,那么库内部函数互相调用时怎么办?如果写死绝对地址,库一旦被映射到不同基址就全乱套了。
解决方案是 PIC(Position Independent Code,位置无关代码)。库内部的编址也采用“从 0 开始的偏移量”。当库被映射到进程虚拟空间的某个起始地址(比如 0x7f1234000),库内某个函数的入口是在库内偏移 0x233 处,那么实际虚拟地址就是库起始地址 + 偏移量。
但这还不够。因为主程序调用库函数时,代码段是只读的,你不能直接在主程序的代码里写死库函数的最终地址。怎么办?
GOT(Global Offset Table,全局偏移表)登场。
- GOT 存放在数据段(可读写),每个进程有自己独立的 GOT。
- 可执行程序不在代码段直接写
call printf,而是call printf@GOT。 - 链接时,GOT 表项先记录库的偏移量和库名;加载完成后,动态链接器把库的实际起始虚拟地址填进 GOT。
- 从此,代码段一行不改,只改数据段的 GOT 表,程序就能正确跳到库函数。
这完美解决了“代码段只读”与“需要动态修正地址”之间的矛盾。
4.4 PLT:延迟绑定(Lazy Binding)
如果一个程序依赖 10 个动态库、涉及 1000 个库函数,启动时就把这 1000 个地址全部解析并填入 GOT,会非常慢。很多函数可能整个生命周期都不会被调用。
PLT(Procedure Linkage Table,过程链接表) 实现了延迟绑定:
- 代码中
call printf实际上先跳到printf@PLT。 - 第一次调用时,PLT 是一段“桩代码”,它会把控制权交给动态链接器:“帮我找一下
printf的真身在哪”。 - 动态链接器找到真实地址后,把地址写回 GOT 表。
- 第二次再调用
printf,直接通过 GOT 跳转到真实地址,不再经过 PLT 解析。
这就是“首次调用触发重定位,后续调用直查 GOT”的延迟绑定机制,兼顾了启动速度与运行效率。
下面是首次调用 printf 时延迟绑定的完整流程图,标注了代码段(只读)与数据段(可写)的边界,以及 GOT 表项地址的变化过程:
流程解读:
- 第一次调用:
call printf@PLT进入 PLT 桩代码,此时GOT[printf]还指向 PLT 内部的下一条指令(PLT+6),于是继续 push 重定位索引并跳转到动态链接器。 - 动态链接器解析:根据重定位索引查找
printf在libc.so中的真实虚拟地址。 - 回填 GOT:动态链接器把真实地址写回数据段的
GOT[printf],代码段一行未改。 - 第二次调用:
call printf@PLT再次进入桩代码,此时GOT[printf]已指向真实地址,直接jmp到printf本体,不再经过动态链接器。
4.5 库依赖库:每个 ELF 都有自己的 GOT
不仅是可执行程序调用动态库,动态库之间也可以相互依赖。比如库 A 调用库 B 的函数。因为每个 ELF(无论可执行文件还是 .so)都有自己的代码段和数据段,所以每个库都有自己的 GOT。库 A 通过查自己的 GOT,找到库 B 的方法地址。这也是 ELF 格式统一性的体现。
五、总结:一张图看清从源码到 CPU 的全链路
这堂课的终极意义,是把看似孤立的编译原理、操作系统文件系统、内存管理、进程加载串成了一条线:
- 编译与静态链接:多个
.c→.o→ 合并 Section、解析符号、地址重定位 → 生成 ELF 可执行文件。此时程序内部已基于平坦模式从 0 编址(逻辑地址/虚拟地址)。 - 加载准备:操作系统通过文件系统找到 ELF,读取 ELF Header 拿到 Entry Point,读取 Program Header 初始化
mm_struct和vm_area_struct。 - 内存映射:Segment 被加载到物理内存,页表建立虚拟地址到物理地址的映射。权限由 ELF 的 Flag 位决定。
- 启动与动态链接:CPU 的
EIP被填入_start虚拟地址。_start初始化运行环境,调用动态链接器加载.so,通过 GOT/PLT 完成运行时重定位。 - 进入 main:一切就绪后,最终调用
libc_start_main,进入用户编写的main函数。
虚拟地址空间是这一切的核心桥梁:它让编译器、链接器、操作系统、CPU 能用同一套“地址语言”对话。编译器在磁盘上按虚拟地址编好程序,操作系统用这些虚拟地址初始化进程空间,CPU 通过页表把虚拟地址翻译为物理地址取指执行。
下堂课,我们将进入进程间通信(IPC)的世界,开发环境也将切换为 C++ 与 VS Code。但那已经是另一个故事了。
附:课堂核心工具速查表
| 工具/命令 | 作用 |
|---|---|
readelf -S <file> | 查看 Section Header Table(编译链接视角) |
readelf -l <file> | 查看 Program Header Table 及 Section → Segment 映射(执行加载视角) |
readelf -h <file> | 查看 ELF Header(Magic、Entry Point、文件类型等) |
readelf -s <file> | 查看符号表(Defined / Undefined 符号) |
objdump -d <file> | 反汇编代码段,查看 call 指令地址,验证重定位 |
ldd <executable> | 查看可执行文件依赖的动态库 |
gcc -c | 编译不链接,生成 .o 可重定位目标文件 |
./a.out 背后的 _start | 程序真正入口,负责初始化与动态链接调度 |
file <file> | 命令用于识别文件类型 |
下面是整篇文章的完整链路总览图,从源码到 CPU 取指执行:
图解: 从源码编译、静态链接生成 ELF,到操作系统加载、内存映射、动态链接,最终进入 main 函数——虚拟地址空间贯穿始终,是这一切的核心桥梁。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 19
 0
- 0


 已为社区贡献5条内容

所有评论(0)