科普文:软件架构之Linux系列【linux内核:Oops调试方法】
概叙
科普文:软件架构之Linux系列【linux内核调试技术汇总】-CSDN博客
科普文:软件架构之Linux系列【linux内核数据结构汇总】-CSDN博客
用Linux,总有死机的时候,如果运气好,会看到一些所谓”Oops”信息(在屏幕上或系统日志中),Oops这个英文单词的意思是“哎呀”,当内核出错时(比如访问非法地址),输出的信息就成为Oops信息,Oops可以看成是内核级的Segmentation Fault。
内核开发比用户空间开发更难的一个因素就是内核调试艰难。内核错误往往会导致系统宕机,很难保留出错时的现场,调试内核的关键在于你的对内核的深刻理解。
一、调试前的准备
在调试一个 bug 之前,我们所要做的准备工作有:
- 有一个被确认的 bug。
- 包含这个 bug 的内核版本号,需要分析出这个 bug 在哪一个版本被引入,这个对于解决问题有极大的帮助。可以采用二分查找法来逐步锁定 bug 引入版本号。
- 对内核代码理解越深刻越好,同时还需要一点点运气。
- 该 bug 可以复现。如果能够找到复现规律,那么离找到问题的原因就不远了。
- 最小化系统。把可能产生 bug 的因素逐一排除掉。
二、内核异常
内核异常的级别大致分为三个:BUG、oops、panic。
2.1BUG
BUG 是指那些不符合内核的正常设计,但内核能够检测出来并且对系统运行不会产生影响的问题,比如在原子上下文中休眠,在内核中用 BUG 标识。
有过驱动调试经验的人肯定都知道这个东西,这里的 BUG 跟我们一般认为的 “软件缺陷” 可不是一回事,这里说的 BUG() 其实是linux 内核中用于拦截内核程序超出预期的行为,属于软件主动汇报异常的一种机制。
这里有个疑问,就是什么时候会用到呢?
一般来说有两种用到的情况:
一是软件开发过程中,若发现代码逻辑出现致命 fault 后就可以调用BUG()让kernel死掉(类似于assert),这样方便于定位问题,从而修正代码执行逻辑;
另外一种情况就是,由于某种特殊原因(通常是为了debug而需抓ramdump),我们需要系统进入kernel panic的情况下使用;
对于 arm64 来说 BUG() 定义如下:
arch/arm64/include/asm/bug.h
#ifndef _ARCH_ARM64_ASM_BUG_H
#define _ARCH_ARM64_ASM_BUG_H
#include <linux/stringify.h>
#include <asm/asm-bug.h>
#define __BUG_FLAGS(flags)				\
	asm volatile (__stringify(ASM_BUG_FLAGS(flags)));

#define BUG() do {					\
	__BUG_FLAGS(0);					\
	unreachable();					\
} while (0)
#define __WARN_FLAGS(flags) __BUG_FLAGS(BUGFLAG_WARNING|(flags))
#define HAVE_ARCH_BUG
#include <asm-generic/bug.h>
#endif /* ! _ARCH_ARM64_ASM_BUG_H */
注意最后的 define HAVE_ARCH_BUG ,对于arm64 架构来说,会通过 include asm-generict/bug.h对 BUG() 进行重定义。
include/asm-generic/bug.h

#ifndef HAVE_ARCH_BUG
#define BUG() do { \
	printk("BUG: failure at %s:%d/%s()!\n", __FILE__, __LINE__, __func__); \
	barrier_before_unreachable(); \
	panic("BUG!"); \
} while (0)
#endif

#ifndef HAVE_ARCH_BUG_ON
#define BUG_ON(condition) do { if (unlikely(condition)) BUG(); } while (0)
#endif
也就是在 arm64 架构中 BUG() 和 BUG_ON() 都是执行的 panic()。而对于 arm 32位架构来说,BUG() 会向CPU 下发一条未定义指令而触发ARM 发起未定义指令异常,随后进入 kernel 异常处理流程,通过调用die() 经历Oops 和 panic。
2.2oops
Oops 就意外着内核出了异常,此时会将产生异常时出错原因,CPU的状态,出错的指令地址、数据地址及其他寄存器,函数调用的顺序甚至是栈里面的内容都打印出来,然后根据异常的严重程度来决定下一步的操作:杀死导致异常的进程或者挂起系统。
例如,在编写驱动或内核模块时,常常会显示或隐式地对指针进行非法取值或使用不正确的指针,导致内核发生一个 oops 错误。当处理器在内核空间中访问一个分发的指针时,因为虚拟地址到物理地址的映射关系还没有建立,会触发一个缺页中断,在缺页中断中该地址是非法的,内核无法正确地为该地址建立映射关系,所以内核触发一个oops 错误。
代码如下:
arch/arm64/mm/fault.c
static void die_kernel_fault(const char *msg, unsigned long addr,
			     unsigned int esr, struct pt_regs *regs)
{
	bust_spinlocks(1);

	pr_alert("Unable to handle kernel %s at virtual address %016lx\n", msg,
		 addr);

	mem_abort_decode(esr);

	show_pte(addr);
	die("Oops", regs, esr);
	bust_spinlocks(0);
	do_exit(SIGKILL);
}
通过 die() 会进行oops 异常处理,详细的 die() 函数流程看第 3 节。当出现 oops,并且如果有源码,可以通过 arm 的 arch64-linux-gnu-objdump 工具看到出错的函数的汇编情况,也可以通过 GDB 工具分析。如果出错的地方为内核函数,可以使用 vmlinux 文件。
如果没有源码,对于没有编译符号表的二进制文件,可以使用:
arch64-linux-gnu-objdump -d oops.ko命令来转储 oops.ko 文件内核也提供了一个非常好用的脚本,可以快速定位问题,该脚本位于 Linux 源码目录下的 scripts/decodecode 中,会把出错的 oops 日志信息转换成直观有用的汇编代码,并且告知具体出错的汇编语句,这对于分析没有源码的 oops 错误非常有用。
2.3die()
arch/arm64/kernel/traps.c

static DEFINE_RAW_SPINLOCK(die_lock);

/*
 * This function is protected against re-entrancy.
 */
void die(const char *str, struct pt_regs *regs, int err)
{
	int ret;
	unsigned long flags;

	raw_spin_lock_irqsave(&die_lock, flags);

	oops_enter();

	console_verbose();
	bust_spinlocks(1);
	ret = __die(str, err, regs);

	if (regs && kexec_should_crash(current))
		crash_kexec(regs);

	bust_spinlocks(0);
	add_taint(TAINT_DIE, LOCKDEP_NOW_UNRELIABLE);
	oops_exit();

	if (in_interrupt())
		panic("Fatal exception in interrupt");
	if (panic_on_oops)
		panic("Fatal exception");

	raw_spin_unlock_irqrestore(&die_lock, flags);

	if (ret != NOTIFY_STOP)
		do_exit(SIGSEGV);
}oops_enter() ---> oops_exit() 为Oops 的处理流程,获取console 的log 级别,并通过 __die() 通过对Oops 感兴趣的模块进行callback,打印模块状态不为 MODULE_STATE_UNFORMED 的模块信息,打印PC、LR、SP、x0 等寄存器信息,打印调用栈信息,等等。
(1)__die()
arch/arm64/kernel/traps.c

static int __die(const char *str, int err, struct pt_regs *regs)
{
	static int die_counter;
	int ret;

	pr_emerg("Internal error: %s: %x [#%d]" S_PREEMPT S_SMP "\n",
		 str, err, ++die_counter);

	/* trap and error numbers are mostly meaningless on ARM */
	ret = notify_die(DIE_OOPS, str, regs, err, 0, SIGSEGV);
	if (ret == NOTIFY_STOP)
		return ret;

	print_modules();
	show_regs(regs);

	dump_kernel_instr(KERN_EMERG, regs);

	return ret;
}
打印 EMERG 的log,Internal error: oops.....;
- notify_die() 会通知所有对 Oops 感兴趣的模块并进行callback;
- print_modules() 打印模块状态不为 MODULE_STATE_UNFORMED 的模块信息;
- show_regs() 打印PC、LR、SP 等寄存器的信息,同时打印调用堆栈信息;
- dump_kernel_instr() 打印 pc指针和前4条指令;
这里不过多的剖析,感兴趣的可以查看下源码。这里需要注意的是 notify_die() 会通知所有的Oops 感兴趣的模块,模块会通过函数 register_die_notifier() 将callback 注册到全局结构体变量 die_chain 中(多个模块注册进来形成一个链表),然后在通过 notify_die() 函数去解析这个 die_chain,并分别调用callback:
kernel/notifier.c

static ATOMIC_NOTIFIER_HEAD(die_chain);

int notrace notify_die(enum die_val val, const char *str,
	       struct pt_regs *regs, long err, int trap, int sig)
{
	struct die_args args = {
		.regs	= regs,
		.str	= str,
		.err	= err,
		.trapnr	= trap,
		.signr	= sig,

	};
	RCU_LOCKDEP_WARN(!rcu_is_watching(),
			   "notify_die called but RCU thinks we're quiescent");
	return atomic_notifier_call_chain(&die_chain, val, &args);
}
NOKPROBE_SYMBOL(notify_die);

int register_die_notifier(struct notifier_block *nb)
{
	vmalloc_sync_mappings();
	return atomic_notifier_chain_register(&die_chain, nb);
}
(2)oops同时有可能panic
从上面 die() 函数最后看到,oops_exit() 之后也有可能进入panic():
arch/arm64/kernel/traps.c

void die(const char *str, struct pt_regs *regs, int err)
{
    ...

	if (in_interrupt())
		panic("Fatal exception in interrupt");
	if (panic_on_oops)
		panic("Fatal exception");
    ...
}
处于中断或panic_on_oops 打开时进入 panic。
中断的可能性:
- 硬件 IRQ;
- 软件 IRQ;
- NMI;
panic_on_oops 的值受 CONFIG_PANIC_ON_OOPS_VALUE 影响。当然该值也可以通过节点/proc/sys/kernel/panic_on_oops 进行动态修改。
2.4panic
panic 本意是“恐慌”的意思,这里意旨 kernel 发生了致命错误导致无法继续运行下去的情况。根据实际情况 Oops最终也可能会导致panic 的发生。
kernel/panic.c/**
* panic - halt the system
* @fmt: The text string to print
*
* Display a message, then perform cleanups.
*
* This function never returns.
*/
void panic(const char *fmt, ...)
{
static char buf[1024];
va_list args;
long i, i_next = 0, len;
int state = 0;
int old_cpu, this_cpu;
bool _crash_kexec_post_notifiers = crash_kexec_post_notifiers;
//禁止本地中断,避免出现死锁,因为无法防止中断处理程序(在获得panic锁后运行)再次被调用panic
local_irq_disable();
//禁止任务抢占
preempt_disable_notrace();
//通过this_cpu确认是否调用panic() 的cpu是否为panic_cpu;
//即,只允许一个CPU执行该代码,通过 panic_smp_self_stop() 保证当一个CPU执行panic时,
//其他CPU处于停止或等待状态;
this_cpu = raw_smp_processor_id();
old_cpu = atomic_cmpxchg(&panic_cpu, PANIC_CPU_INVALID, this_cpu);
if (old_cpu != PANIC_CPU_INVALID && old_cpu != this_cpu)
panic_smp_self_stop();
//把console的打印级别放开
console_verbose();
bust_spinlocks(1);
va_start(args, fmt);
len = vscnprintf(buf, sizeof(buf), fmt, args);
va_end(args);
if (len && buf[len - 1] == '\n')
buf[len - 1] = '\0';
//解析panic所携带的message,前缀为Kernel panic - not syncing
pr_emerg("Kernel panic - not syncing: %s\n", buf);
#ifdef CONFIG_DEBUG_BUGVERBOSE
/*
* Avoid nested stack-dumping if a panic occurs during oops processing
*/
if (!test_taint(TAINT_DIE) && oops_in_progress <= 1)
dump_stack();
#endif
//如果kgdb使能,即CONFIG_KGDB为y,在停掉所有其他CPU之前,跳转kgdb断点运行
kgdb_panic(buf);
if (!_crash_kexec_post_notifiers) {
printk_safe_flush_on_panic();
//会根据当前是否设置了转储内核(使能CONFIG_KEXEC_CORE)确定是否实际执行转储操作;
//如果执行转储则会通过 kexec 将系统切换到新的kdump 内核,并且不会再返回;
//如果不执行转储,则继续后面流程;
__crash_kexec(NULL);
//停掉其他CPU,只留下当前CPU干活
smp_send_stop();
} else {
/*
* If we want to do crash dump after notifier calls and
* kmsg_dump, we will need architecture dependent extra
* works in addition to stopping other CPUs.
*/
crash_smp_send_stop();
}
//通知所有对panic感兴趣的模块进行回调,添加一些kmsg信息到输出
atomic_notifier_call_chain(&panic_notifier_list, 0, buf);
/* Call flush even twice. It tries harder with a single online CPU */
printk_safe_flush_on_panic();
//dump 内核log buffer中的log信息
kmsg_dump(KMSG_DUMP_PANIC);
/*
* If you doubt kdump always works fine in any situation,
* "crash_kexec_post_notifiers" offers you a chance to run
* panic_notifiers and dumping kmsg before kdump.
* Note: since some panic_notifiers can make crashed kernel
* more unstable, it can increase risks of the kdump failure too.
*
* Bypass the panic_cpu check and call __crash_kexec directly.
*/
if (_crash_kexec_post_notifiers)
__crash_kexec(NULL);
#ifdef CONFIG_VT
unblank_screen();
#endif
console_unblank();
//关掉所有debug锁
debug_locks_off();
console_flush_on_panic(CONSOLE_FLUSH_PENDING);
panic_print_sys_info();
if (!panic_blink)
panic_blink = no_blink;
//如果sysctl配置了panic_timeout > 0则在panic_timeout后重启系统
//首先,这里会每隔100ms重启 NMI watchdog
if (panic_timeout > 0) {
/*
* Delay timeout seconds before rebooting the machine.
* We can't use the "normal" timers since we just panicked.
*/
pr_emerg("Rebooting in %d seconds..\n", panic_timeout);
for (i = 0; i < panic_timeout * 1000; i += PANIC_TIMER_STEP) {
touch_nmi_watchdog();
if (i >= i_next) {
i += panic_blink(state ^= 1);
i_next = i + 3600 / PANIC_BLINK_SPD;
}
mdelay(PANIC_TIMER_STEP);
}
}
//其次,这里确定reboot_mode,并重启系统
if (panic_timeout != 0) {
/*
* This will not be a clean reboot, with everything
* shutting down. But if there is a chance of
* rebooting the system it will be rebooted.
*/
if (panic_reboot_mode != REBOOT_UNDEFINED)
reboot_mode = panic_reboot_mode;
emergency_restart();
}
#ifdef __sparc__
{
extern int stop_a_enabled;
/* Make sure the user can actually press Stop-A (L1-A) */
stop_a_enabled = 1;
pr_emerg("Press Stop-A (L1-A) from sun keyboard or send break\n"
"twice on console to return to the boot prom\n");
}
#endif
#if defined(CONFIG_S390)
disabled_wait();
#endif
pr_emerg("---[ end Kernel panic - not syncing: %s ]---\n", buf);
/* Do not scroll important messages printed above */
suppress_printk = 1;
local_irq_enable();
for (i = 0; ; i += PANIC_TIMER_STEP) {
touch_softlockup_watchdog();
if (i >= i_next) {
i += panic_blink(state ^= 1);
i_next = i + 3600 / PANIC_BLINK_SPD;
}
mdelay(PANIC_TIMER_STEP);
}
}
EXPORT_SYMBOL(panic);详细信息见代码注释。panic_timeout 是根据节点 /proc/sys/kernel/panic 值配置,用以指定在重启系统之前需要 wait 的时长。
(1)panic_print_sys_info()
kernel/panic.c

#define PANIC_PRINT_TASK_INFO		0x00000001
#define PANIC_PRINT_MEM_INFO		0x00000002
#define PANIC_PRINT_TIMER_INFO		0x00000004
#define PANIC_PRINT_LOCK_INFO		0x00000008
#define PANIC_PRINT_FTRACE_INFO		0x00000010
#define PANIC_PRINT_ALL_PRINTK_MSG	0x00000020

static void panic_print_sys_info(void)
{
	if (panic_print & PANIC_PRINT_ALL_PRINTK_MSG)
		console_flush_on_panic(CONSOLE_REPLAY_ALL);

	if (panic_print & PANIC_PRINT_TASK_INFO)
		show_state();

	if (panic_print & PANIC_PRINT_MEM_INFO)
		show_mem(0, NULL);

	if (panic_print & PANIC_PRINT_TIMER_INFO)
		sysrq_timer_list_show();

	if (panic_print & PANIC_PRINT_LOCK_INFO)
		debug_show_all_locks();

	if (panic_print & PANIC_PRINT_FTRACE_INFO)
		ftrace_dump(DUMP_ALL);
}
panic_print 默认值为 0,可以通过 /proc/sys/kernel/panic_print 节点配置,当 panic 发生的时候,用户可以通过如下bit 位配置打印系统信息:
- bit 0:打印所有的进程信息;
- bit 1:打印系统内存信息;
- bit 2:打印定时器信息;
- bit 3:打印当 CONFIG_LOCKEDP 打开时的锁信息;
- bit 4:打印所有 ftrace;
- bit 5:打印串口所有信息;
三、内核调试配置选项
学习编写驱动程序要构建安装自己的内核(标准主线内核)。最重要的原因之一是:内核开发者已经建立了多项用于调试的功能。但是由于这些功能会造成额外的输出,并导致能下降,因此发行版厂商通常会禁止发行版内核中的调试功能。
3.1内核配置
为了实现内核调试,在内核配置上增加了几项:
Kernel hacking ---> 启用选项例如:
slab layer debugging(slab层调试选项) 3.2调试原子操作
从内核 2.5 开发,为了检查各类由原子操作引发的问题,内核提供了极佳的工具。内核提供了一个原子操作计数器,它可以配置成,一旦在原子操作过程中,进城进入睡眠或者做了一些可能引起睡眠的操作,就打印警告信息并提供追踪线索。所以,包括在使用锁的时候调用 schedule (),正使用锁的时候以阻塞方式请求分配内存等,各种潜在的 bug 都能够被探测到。
下面这些选项可以最大限度地利用该特性:
CONFIG_PREEMPT = y 四、引发 bug并打印信息
4.1BUG () 和 BUG_ON ()
一些内核调用可以用来方便标记 bug,提供断言并输出信息。最常用的两个是 BUG () 和 BUG_ON ()。
定义在中:
#ifndef HAVE_ARCH_BUG 当调用这两个宏的时候,它们会引发 OOPS,导致栈的回溯和错误消息的打印。 ※ 可以把这两个调用当作断言使用,如:BUG_ON (bad_thing);
4.2dump_stack()
有些时候,只需要在终端上打印一下栈的回溯信息来帮助你调试。这时可以使用 dump_stack ()。这个函数只在终端上打印寄存器上下文和函数的跟踪线索。
if (!debug_check) {
       printk(KERN_DEBUG “provide some information…/n”);
       dump_stack();
   }
五、printk ()
内核提供的格式化打印函数。
5.1printk 函数的健壮性
健壮性是 printk 最容易被接受的一个特质,几乎在任何地方,任何时候内核都可以调用它(中断上下文、进程上下文、持有锁时、多处理器处理时等)。
5.2printk 函数脆弱之处
在系统启动过程中,终端初始化之前,在某些地方是不能调用的。如果真的需要调试系统启动过程最开始的地方,有以下方法可以使用:
- 使用串口调试,将调试信息输出到其他终端设备。
- 使用 early_printk (),该函数在系统启动初期就有打印能力。但它只支持部分硬件体系。
5.3LOG 等级
printk 和 printf 一个主要的区别就是前者可以指定一个 LOG 等级。内核根据这个等级来判断是否在终端上打印消息。内核把比指定等级高的所有消息显示在终端。
可以使用下面的方式指定一个 LOG 级别: printk(KERN_CRIT “Hello, world!\n”); 注意,第一个参数并不一个真正的参数,因为其中没有用于分隔级别(KERN_CRIT)和格式字符的逗号(,)。KERN_CRIT 本身只是一个普通的字符串(事实上,它表示的是字符串 "<2>";表 1 列出了完整的日志级别清单)。
作为预处理程序的一部分,C 会自动地使用一个名为 字符串串联 的功能将这两个字符串组合在一起。组合的结果是将日志级别和用户指定的格式字符串包含在一个字符串中。
内核使用这个指定 LOG 级别与当前终端 LOG 等级 console_loglevel 来决定是不是向终端打印。 下面是可使用的 LOG 等级:
#define KERN_EMERG      "<0>"   /* system is unusable                            */
#define KERN_ALERT        "<1>"   /* action must be taken immediately     */
#define KERN_CRIT           "<2>"   /* critical conditions                                */
#define KERN_ERR            "<3>"   /* error conditions                                   */
#define KERN_WARNING  "<4>"   /* warning conditions                              */
#define KERN_NOTICE       "<5>"   /* normal but significant condition         */
#define KERN_INFO            "<6>"   /* informational                                       */
#define KERN_DEBUG        "<7>"   /* debug-level messages                       */
#define KERN_DEFAULT     "<d>"   /* Use the default kernel loglevel           */
注意,如果调用者未将日志级别提供给 printk,那么系统就会使用默认值 KERN_WARNING "<4>"(表示只有 KERN_WARNING 级别以上的日志消息会被记录)。由于默认值存在变化,所以在使用时最好指定 LOG 级别。有 LOG 级别的一个好处就是我们可以选择性的输出 LOG。
比如平时我们只需要打印 KERN_WARNING 级别以上的关键性 LOG,但是调试的时候,我们可以选择打印 KERN_DEBUG 等以上的详细 LOG。而这些都不需要我们修改代码,只需要通过命令修改默认日志输出级别:
mtj@ubuntu :~$ cat /proc/sys/kernel/printk
4 4 1 7
mtj@ubuntu :~$ cat /proc/sys/kernel/printk_delay
0
mtj@ubuntu :~$ cat /proc/sys/kernel/printk_ratelimit
5
mtj@ubuntu :~$ cat /proc/sys/kernel/printk_ratelimit_burst
10
第一项定义了 printk API 当前使用的日志级别。这些日志级别表示了控制台的日志级别、默认消息日志级别、最小控制台日志级别和默认控制台日志级别。printk_delay 值表示的是 printk 消息之间的延迟毫秒数(用于提高某些场景的可读性)。
注意,这里它的值为 0,而它是不可以通过 /proc 设置的。printk_ratelimit 定义了消息之间允许的最小时间间隔(当前定义为每 5 秒内的某个内核消息数)。消息数量是由 printk_ratelimit_burst 定义的(当前定义为 10)。
如果您拥有一个非正式内核而又使用有带宽限制的控制台设备(如通过串口), 那么这非常有用。注意,在内核中,速度限制是由调用者控制的,而不是在 printk 中实现的。
如果一个 printk 用户要求进行速度限制,那么该用户就需要调用 printk_ratelimit 函数。
5.4记录缓冲区
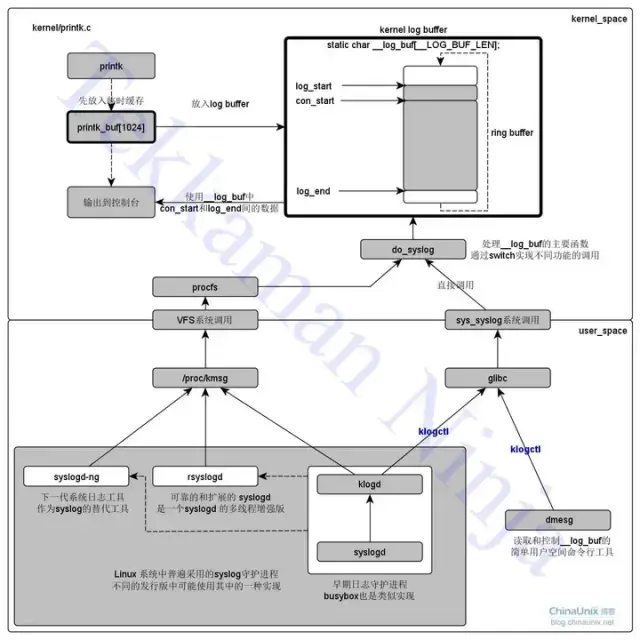
内核消息都被保存在一个 LOG_BUF_LEN 大小的环形队列中。 关于 LOG_BUF_LEN 定义:
#define __LOG_BUF_LEN (1 << CONFIG_LOG_BUF_SHIFT)※ 变量 CONFIG_LOG_BUF_SHIFT 在内核编译时由配置文件定义,对于 i386 平台,其值定义如下(在 linux26/arch/i386/defconfig 中):
CONFIG_LOG_BUF_SHIFT=18记录缓冲区操作:
- ① 消息被读出到用户空间时,此消息就会从环形队列中删除。
- ② 当消息缓冲区满时,如果再有 printk () 调用时,新消息将覆盖队列中的老消息。
- ③ 在读写环形队列时,同步问题很容易得到解决。
※ 这个纪录缓冲区之所以称为环形,是因为它的读写都是按照环形队列的方式进行操作的。
5.5syslogd/klogd
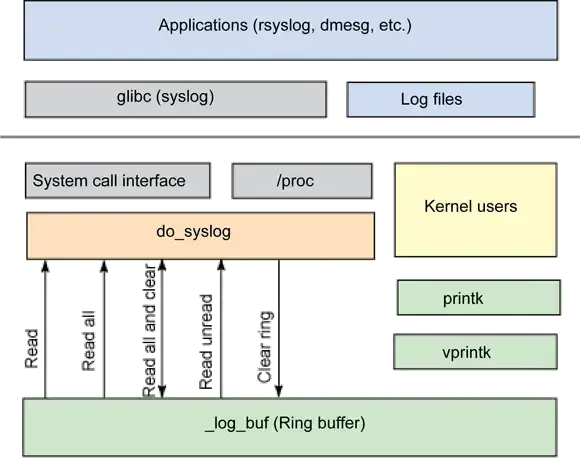
在标准的 Linux 系统上,用户空间的守护进程klogd 从纪录缓冲区中获取内核消息,再通过 syslogd 守护进程把这些消息保存在系统日志文件中。klogd 进程既可以从 /proc/kmsg 文件中,也可以通过 syslog () 系统调用读取这些消息。
默认情况下,它选择读取 /proc 方式实现。klogd 守护进程在消息缓冲区有新的消息之前,一直处于阻塞状态。
一旦有新的内核消息,klogd 被唤醒,读出内核消息并进行处理。
默认情况下,处理例程就是把内核消息传给 syslogd 守护进程。syslogd 守护进程一般把接收到的消息写入 /var/log/messages 文件中。不过,还是可以通过 /etc/syslog.conf 文件来进行配置,可以选择其他的输出文件。
5.6dmesg
dmesg 命令也可用于打印和控制内核环缓冲区。这个命令使用 klogctl 系统调用来读取内核环缓冲区,并将它转发到标准输出(stdout)。这个命令也可以用来清除内核环缓冲区(使用 -c 选项),设置控制台日志级别(-n 选项),以及定义用于读取内核日志消息的缓冲区大小(-s 选项)。
注意,如果没有指定缓冲区大小,那么 dmesg 会使用 klogctl 的 SYSLOG_ACTION_SIZE_BUFFER 操作确定缓冲区大小。
5.7注意
- a) 虽然 printk 很健壮,但是看了源码你就知道,这个函数的效率很低:做字符拷贝时一次只拷贝一个字节,且去调用 console 输出可能还产生中断。所以如果你的驱动在功能调试完成以后做性能测试或者发布的时候千万记得尽量减少 printk 输出,做到仅在出错时输出少量信息。否则往 console 输出无用信息影响性能。
- b) printk 的临时缓存 printk_buf 只有 1K,所有一次 printk 函数只能记录 <1K 的信息到 log buffer,并且 printk 使用的 “ringbuffer”.
5.8内核 printk 和日志系统的总体结构
5.9动态调试
动态调试是通过动态的开启和禁止某些内核代码来获取额外的内核信息。 首先内核选项 CONFIG_DYNAMIC_DEBUG 应该被设置。所有通过 pr_debug ()/dev_debug () 打印的信息都可以动态的显示或不显示。 可以通过简单的查询语句来筛选需要显示的信息。
- 源文件名
- 函数名
- 行号(包括指定范围的行号)
- 模块名
- 格式化字符串
将要打印信息的格式写入 /dynamic_debug/control 中。
nullarbor:~ # echo 'file svcsock.c line 1603 +p' > 六、内存调试工具
6.1MEMWATCH
MEMWATCH 由 Johan Lindh 编写,是一个开放源代码 C 语言内存错误检测工具,您可以自己下载它。只要在代码中添加一个头文件并在 gcc 语句中定义了 MEMWATCH 之后,您就可以跟踪程序中的内存泄漏和错误了。
MEMWATCH 支持 ANSIC,它提供结果日志纪录,能检测双重释放(double-free)、错误释放(erroneous free)、没有释放的内存(unfreedmemory)、溢出和下溢等等。 清单 1. 内存样本(test1.c)
#include <stdlib.h>
#include <stdio.h>
#include "memwatch.h"
int main(void)
{
 char *ptr1;
 char *ptr2;
 ptr1 = malloc(512);
 ptr2 = malloc(512);
 ptr2 = ptr1;
 free(ptr2);
 free(ptr1);
}
清单 1 中的代码将分配两个 512 字节的内存块,然后指向第一个内存块的指针被设定为指向第二个内存块。结果,第二个内存块的地址丢失,从而产生了内存泄漏。 现在我们编译清单 1 的 memwatch.c。下面是一个 makefile 示例: test1
gcc -DMEMWATCH -DMW_STDIO test1.c memwatch
c -o test1
当您运行 test1 程序后,它会生成一个关于泄漏的内存的报告。清单 2 展示了示例 memwatch.log 输出文件。
清单 2. test1 memwatch.log 文件
MEMWATCH 2.67 Copyright (C) 1992-1999 Johan Lindh
...
double-free: <4> test1.c(15), 0x80517b4 was freed from test1.c(14)
...
unfreed: <2> test1.c(11), 512 bytes at 0x80519e4
{FE FE FE FE FE FE FE FE FE FE FE FE ..............}
Memory usage statistics (global):
 N)umber of allocations made: 2
 L)argest memory usage : 1024
 T)otal of all alloc() calls: 1024
 U)nfreed bytes totals : 512
MEMWATCH 为您显示真正导致问题的行。如果您释放一个已经释放过的指针,它会告诉您。对于没有释放的内存也一样。日志结尾部分显示统计信息,包括泄漏了多少内存,使用了多少内存,以及总共分配了多少内存。
6.2YAMD
YAMD 软件包由 Nate Eldredge 编写,可以查找 C 和 C++ 中动态的、与内存分配有关的问题。在撰写本文时,YAMD 的最新版本为 0.32。请下载 yamd-0.32.tar.gz。执行 make 命令来构建程序;然后执行 make install 命令安装程序并设置工具。 一旦您下载了 YAMD 之后,请在 test1.c 上使用它。请删除 #include memwatch.h 并对 makefile 进行如下小小的修改: 使用 YAMD 的 test1
gcc -g test1.c -o test1清单 3 展示了来自 test1 上的 YAMD 的输出。 清单 3. 使用 YAMD 的 test1 输出
YAMD version 0.32
Executable: /usr/src/test/yamd-0.32/test1
...
INFO: Normal allocation of this block
Address 0x40025e00, size 512
...
INFO: Normal allocation of this block
Address 0x40028e00, size 512
...
INFO: Normal deallocation of this block
Address 0x40025e00, size 512
...
ERROR: Multiple freeing At
free of pointer already freed
Address 0x40025e00, size 512
...
WARNING: Memory leak
Address 0x40028e00, size 512
WARNING: Total memory leaks:
1 unfreed allocations totaling 512 bytes
*** Finished at Tue ... 10:07:15 2002
Allocated a grand total of 1024 bytes 2 allocations
Average of 512 bytes per allocation
Max bytes allocated at one time: 1024
24 K alloced internally / 12 K mapped now / 8 K max
Virtual program size is 1416 K
End.
YAMD 显示我们已经释放了内存,而且存在内存泄漏。让我们在清单 4 中另一个样本程序上试试 YAMD。 清单 4. 内存代码(test2.c)
#include <stdlib.h>
#include <stdio.h>
int main(void)
{
 char *ptr1;
 char *ptr2;
 char *chptr;
 int i = 1;
 ptr1 = malloc(512);
 ptr2 = malloc(512);
 chptr = (char *)malloc(512);
 for (i; i <= 512; i++) {
   chptr[i] = 'S';
 }
 ptr2 = ptr1;
 free(ptr2);
 free(ptr1);
 free(chptr);
}
您可以使用下面的命令来启动 YAMD:
./run-yamd /usr/src/test/test2/test2清单 5 显示了在样本程序 test2 上使用 YAMD 得到的输出。YAMD 告诉我们在 for 循环中有 “越界(out-of-bounds)” 的情况。 清单 5. 使用 YAMD 的 test2 输出
Running /usr/src/test/test2/test2
Temp output to /tmp/yamd-out.1243
*********
./run-yamd: line 101: 1248 Segmentation fault (core dumped)
YAMD version 0.32
Starting run: /usr/src/test/test2/test2
Executable: /usr/src/test/test2/test2
Virtual program size is 1380 K
...
INFO: Normal allocation of this block
Address 0x40025e00, size 512
...
INFO: Normal allocation of this block
Address 0x40028e00, size 512
...
INFO: Normal allocation of this block
Address 0x4002be00, size 512
ERROR: Crash
...
Tried to write address 0x4002c000
Seems to be part of this block:
Address 0x4002be00, size 512
...
Address in question is at offset 512 (out of bounds)
Will dump core after checking heap.
Done.
MEMWATCH 和 YAMD 都是很有用的调试工具,它们的使用方法有所不同。对于 MEMWATCH,您需要添加包含文件 memwatch.h 并打开两个编译时间标记。对于链接(link)语句,YAMD 只需要 -g 选项。
6.3Electric Fence
多数 Linux 分发版包含一个 Electric Fence 包,不过您也可以选择下载它。Electric Fence 是一个由 Bruce Perens 编写的 malloc () 调试库。它就在您分配内存后分配受保护的内存。如果存在 fencepost 错误(超过数组末尾运行),程序就会产生保护错误,并立即结束。通过结合 Electric Fence 和 gdb,您可以精确地跟踪到哪一行试图访问受保护内存。ElectricFence 的另一个功能就是能够检测内存泄漏。
6.4strace
strace 命令是一种强大的工具,它能够显示所有由用户空间程序发出的系统调用。strace 显示这些调用的参数并返回符号形式的值。strace 从内核接收信息,而且不需要以任何特殊的方式来构建内核。
将跟踪信息发送到应用程序及内核开发者都很有用。
在清单 6 中,分区的一种格式有错误,清单显示了 strace 的开头部分,内容是关于调出创建文件系统操作(mkfs )的。strace 确定哪个调用导致问题出现。 清单 6. mkfs 上 strace 的开头部分
execve("/sbin/mkfs.jfs", ["mkfs.jfs", "-f", "/dev/test1"], &
...
open("/dev/test1", O_RDWR|O_LARGEFILE) = 4
stat64("/dev/test1", {st_mode=&, st_rdev=makedev(63, 255), ...}) = 0
ioctl(4, 0x40041271, 0xbfffe128) = -1 EINVAL (Invalid argument)
write(2, "mkfs.jfs: warning - cannot setb" ..., 98mkfs.jfs: warning -
cannot set blocksize on block device /dev/test1: Invalid argument )
 = 98
stat64("/dev/test1", {st_mode=&, st_rdev=makedev(63, 255), ...}) = 0
open("/dev/test1", O_RDONLY|O_LARGEFILE) = 5
ioctl(5, 0x80041272, 0xbfffe124) = -1 EINVAL (Invalid argument)
write(2, "mkfs.jfs: can\'t determine device"..., ..._exit(1)
= ?清单 6 显示 ioctl 调用导致用来格式化分区的 mkfs 程序失败。
ioctl BLKGETSIZE64 失败。( BLKGET-SIZE64 在调用 ioctl 的源代码中定义。) BLKGETSIZE64 ioctl 将被添加到 Linux 中所有的设备,而在这里,逻辑卷管理器还不支持它。
因此,如果 BLKGETSIZE64 ioctl 调用失败,mkfs 代码将改为调用较早的 ioctl 调用;这使得 mkfs 适用于逻辑卷管理器。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐


 17
 0
- 0


 已为社区贡献14条内容

所有评论(0)