Linux 反向映射 rmap 机制深入解析:从 struct page 反查 vm_area_struct 源码
Linux 反向映射 rmap 机制深入解析:从 struct page 反查 vm_area_struct 源码
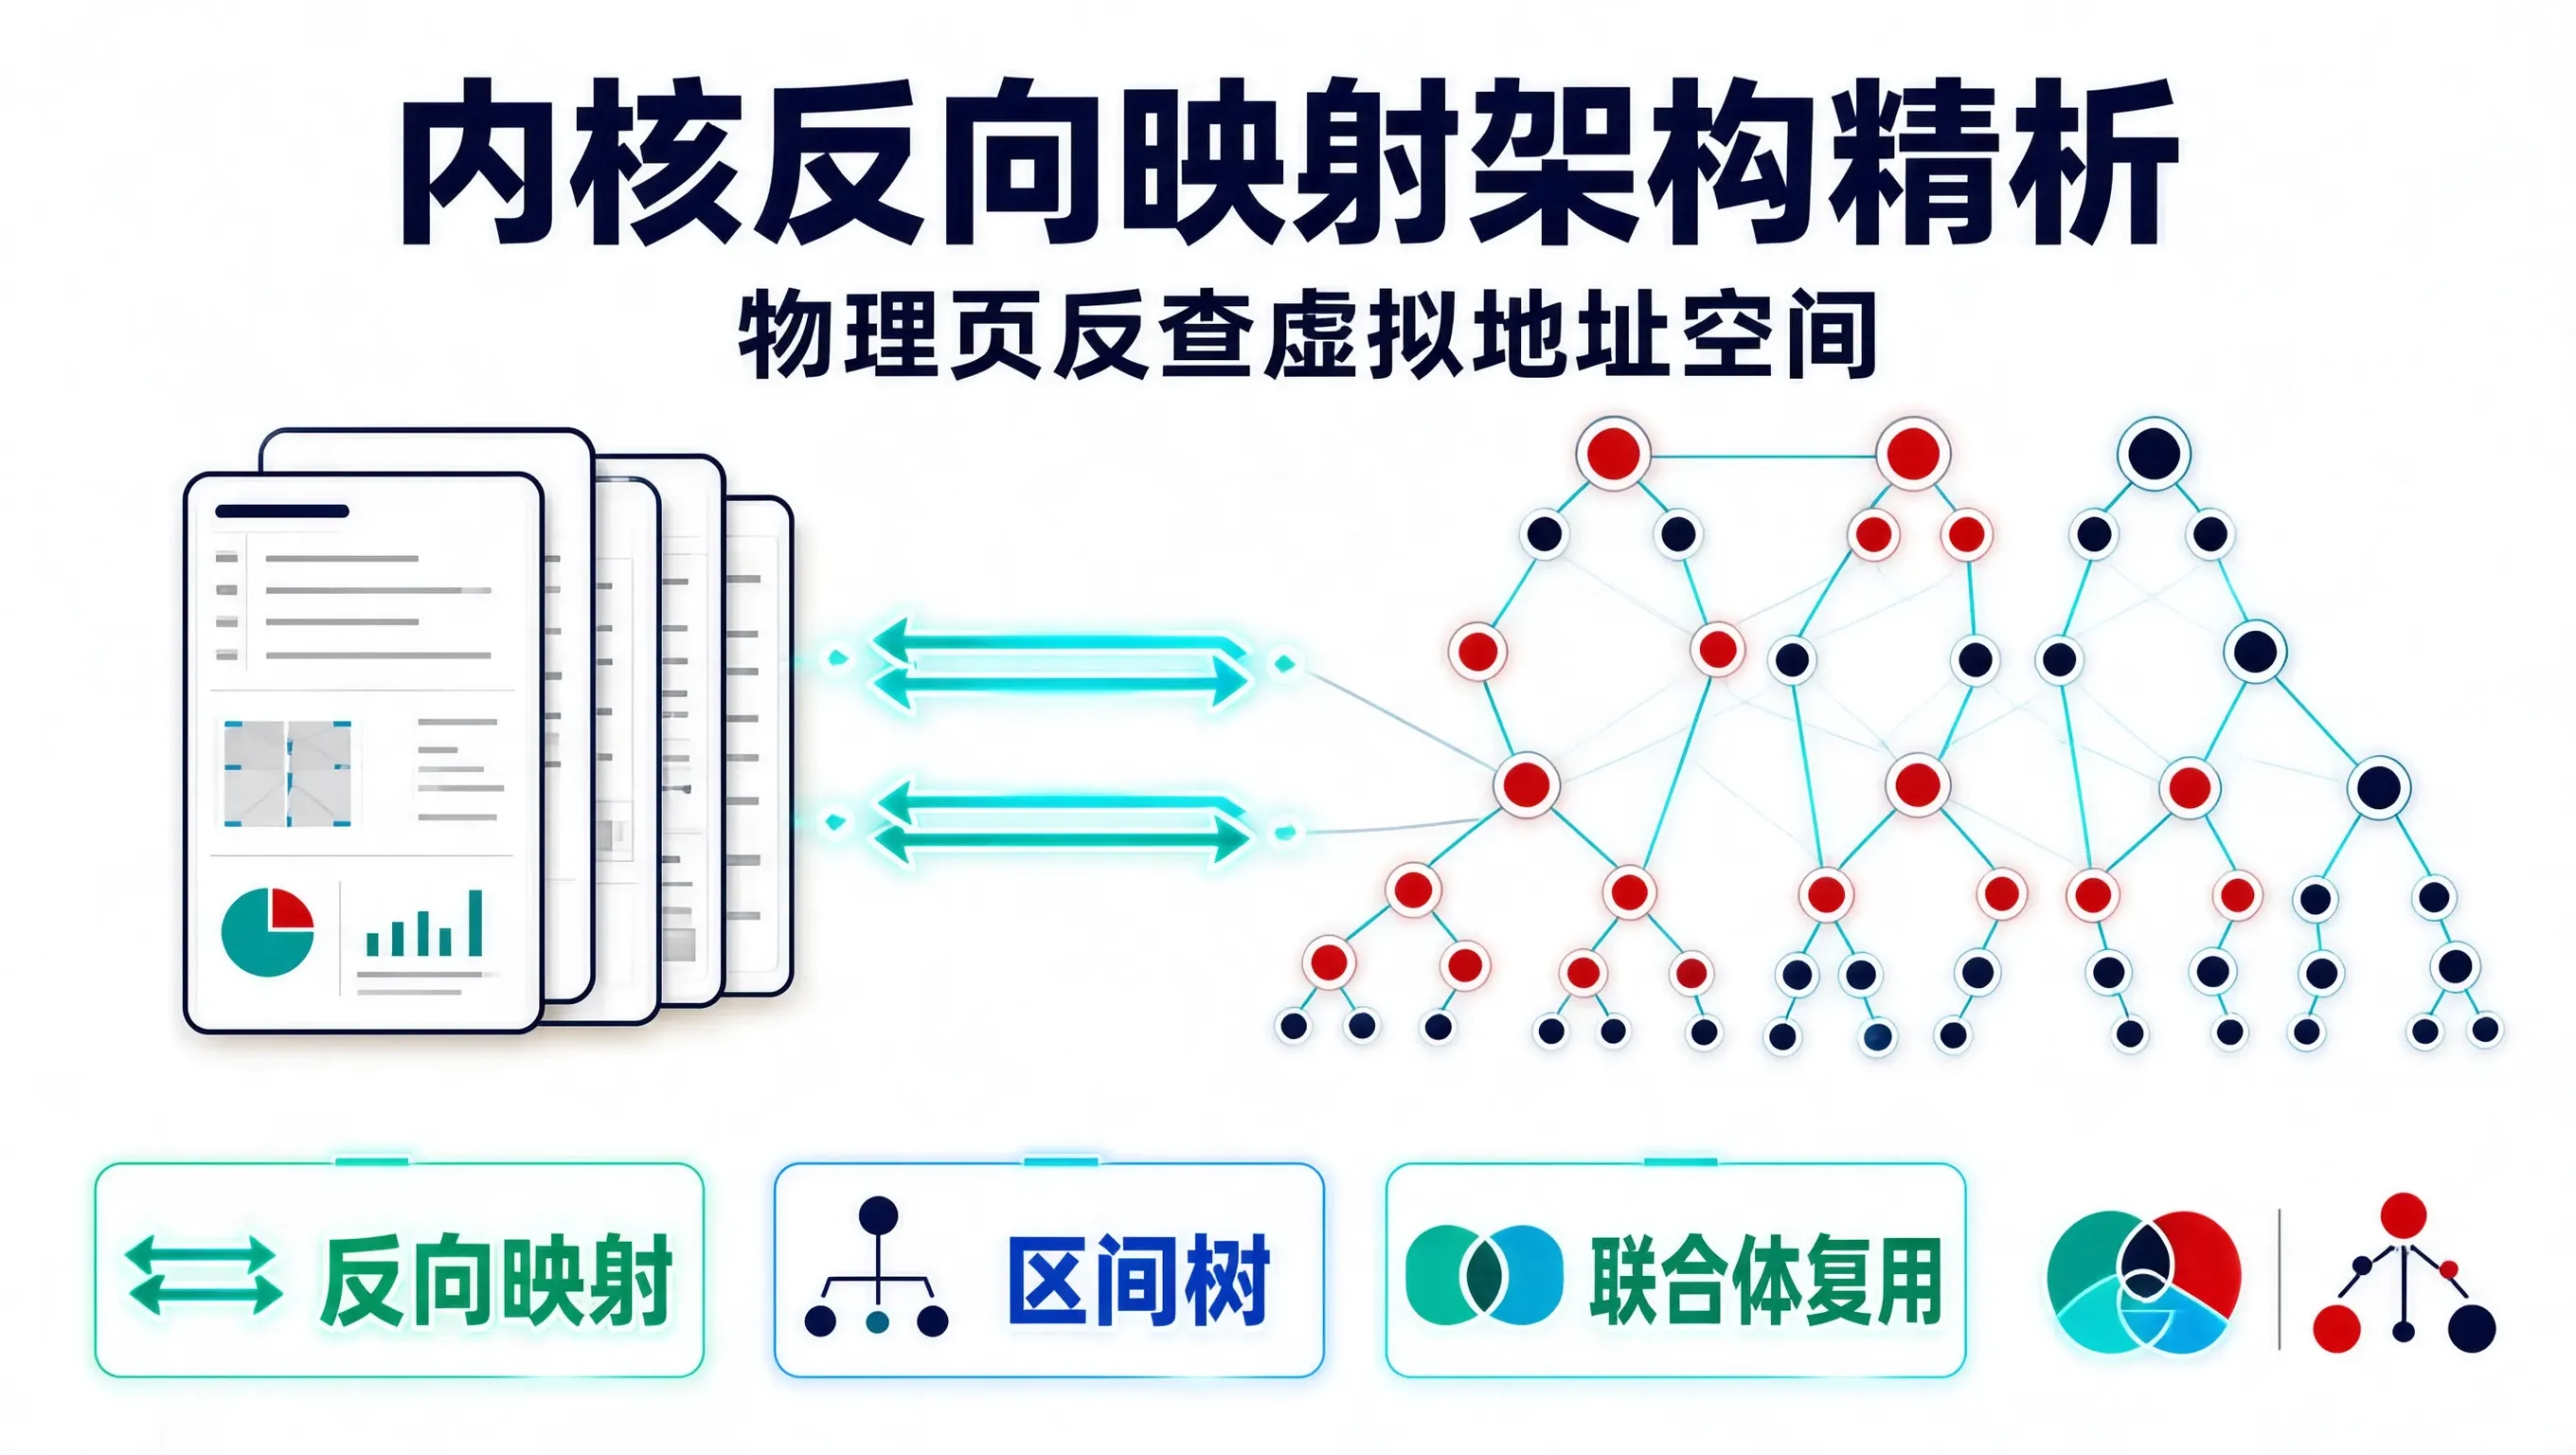
在现代操作系统的虚拟内存管理体系中,CPU 硬件通过 MMU 和多级页表(PGD $\to$ P4D $\to$ PUD $\to$ PMD $\to$ PTE)完成从“虚拟地址(VA)”到“物理地址(PA)”的正向转换,这一过程极其高效。
然而,在操作系统执行**物理内存页回收(Page Reclaim / Swap)、内存紧缩碎片整理(Compaction)、写时复制(COW)或内核页迁移(Page Migration)**时,内核面临一个完全相反的命题:
“我现在手里握着一个特定的物理页(
struct page或现代内核中的struct folio),我如何以极低的内存开销与极高的时间复杂度,找到所有正在引用这个物理页的进程虚拟地址空间(struct vm_area_struct, 简称 VMA),并修改对应的 PTE 页表项解除映射(Unmap)?”
这就是 Linux 内存子系统中最精妙、设计难度最高的核心机制之一——反向映射(Reverse Mapping,简称 rmap)。
一、 rmap 的演进简史:从内存黑洞到对象反向映射
在 Linux 2.4 到 2.5 早期内核中,内核采用的是粗暴的 pte_chain 链表方案:
每个物理页 struct page 都挂载一个单向链表,链表中的每个节点指向一个引用该物理页的 PTE。
graph TD
    subgraph 早期淘汰方案: pte_chain 方案 (内存黑洞)
        P1[struct page] --> L1[pte_chain 节点 1 -> 进程A PTE]
        L1 --> L2[pte_chain 节点 2 -> 进程B PTE]
        L2 --> L3[pte_chain 节点 N -> ...]
    end

    subgraph 现代 Object-based rmap 架构 (极简指针复用)
        P2[struct page.mapping 联合体] --> AV[struct anon_vma / address_space]
        AV --> RBTree[自平衡红黑树 / 区间树 Interval Tree]
        RBTree --> VMA1[VMA Process A]
        RBTree --> VMA2[VMA Process B]
    end
- 早期痛点:当多个子进程通过
fork()共享父进程的只读物理页时(例如一个只读共享库被 500 个进程加载),每个物理页都需要分配 500 个pte_chain结构体,光是维护反向映射链表消耗的 RAM 就超过了数据本身! - 现代革新:Linux 2.6 引入了基于对象(Object-based)的反向映射,通过复用进程的
vm_area_struct拓扑与区间树,将物理页元数据开销压缩到了极致。
二、 匿名页反向映射(Anon rmap)数据结构剖析
对于堆、栈等匿名页(Anonymous Pages),由于没有底层的 Inode 实体支撑,内核设计了三位一体的核心结构:anon_vma、anon_vma_chain(AVC)和 anon_vma_root。
1. struct page 内部的联合体障眼法
在内核源码 include/linux/mm_types.h 中,struct page 通过字段复用节约每一个字节:
struct page {
    unsigned long flags;
    union {
        struct {
            struct list_head lru;
            /*
             * mapping 字段最低位(bit 0)作为标志位:
             * 若 bit 0 == 1,表示该页为匿名页,指针指向 struct anon_vma;
             * 若 bit 0 == 0,表示该页为文件页,指针指向 struct address_space.
             */
            struct address_space *mapping;
            pgoff_t index;  /* 在对应虚拟区域或文件中的页偏移 */
            /* ... */
        };
        /* ... */
    };
    /* ... */
};
通过 PAGE_MAPPING_ANON 宏判断:
#define PAGE_MAPPING_ANON   0x1
static inline bool PageAnon(struct page *page)
{
    return ((unsigned long)page->mapping & PAGE_MAPPING_ANON) != 0;
}
2. 进程 Fork 时的 AVC 链接拓扑
当父进程 fork() 创建子进程时,父子进程的 VMA 会产生继承关系。为了避免在父子进程频繁 fork/exit 时遍历整个进程树,内核通过 struct anon_vma_chain 构建了一个双向交叉引用网:
classDiagram
    class anon_vma {
        +atomic_t refcount
        +struct anon_vma *root
        +struct rb_root_cached rb_root
    }
    class anon_vma_chain {
        +struct vm_area_struct *vma
        +struct anon_vma *anon_vma
        +struct list_head same_vma
        +struct rb_node rb
    }
    class vm_area_struct {
        +unsigned long vm_start
        +unsigned long vm_end
        +struct list_head anon_vma_chain
        +struct mm_struct *vm_mm
    }
    anon_vma_chain --> anon_vma : 关联
    anon_vma_chain --> vm_area_struct : 关联
    vm_area_struct --> anon_vma_chain : 拥有列表
三、 反向映射的遍历执行流程:rmap_walk
当内核决定回收某个物理页时,会调用 try_to_unmap(),其核心底层统一委托给 rmap_walk():
flowchart TD
    Start[try_to_unmap(struct page *page)] --> CheckType{PageAnon(page) ?}

    CheckType -->|True 匿名页| WalkAnon[rmap_walk_anon()]
    CheckType -->|False 文件页| WalkFile[rmap_walk_file()]

    WalkAnon --> LockAV[获取 page_anon_vma 锁]
    LockAV --> TraverseRB[遍历 anon_vma->rb_root 区间树]
    TraverseRB --> MatchVMA[定位包含 page->index 的候选 VMA]
    MatchVMA --> CalcPTE[通过 vma_address() 计算虚拟地址 VA 并查找 PTE]
    CalcPTE --> UnmapPTE[ptep_clear_flush 解除映射 & 冲刷 TLB]
    UnmapPTE --> FreePage[物理页可安全回收 / 写回 Swap]
核心内核源码调用路径(精简注释):
// mm/rmap.c
bool rmap_walk_anon(struct folio *folio, const struct rmap_walk_control *rwc, bool locked)
{
    struct anon_vma *anon_vma;
    pgoff_t pgoff_start, pgoff_end;
    struct anon_vma_chain *avc;

    // 1. 从 folio/page 中提取 anon_vma 指针并加锁保护
    anon_vma = folio_anon_vma(folio);
    if (!anon_vma)
        return false;

    pgoff_start = folio->index;
    pgoff_end = pgoff_start + folio_nr_pages(folio) - 1;

    // 2. 遍历 anon_vma 内部以虚拟地址区间构建的红黑树 (Interval Tree)
    anon_vma_interval_tree_foreach(avc, &anon_vma->rb_root, pgoff_start, pgoff_end) {
        struct vm_area_struct *vma = avc->vma;
        unsigned long address = vma_address(&folio->page, vma);

        // 3. 回调处理函数 (例如 try_to_unmap_one) 进行 PTE 解除映射
        if (rwc->rmap_one) {
            if (!rwc->rmap_one(folio, vma, address, rwc->arg))
                break;
        }
    }
    return true;
}
四、 文件页反向映射(File rmap)与区间树加速
对于有文件背景(File-backed)的页缓存,反向映射则更加直观:
page->mapping指向该文件 inode 的struct address_space;address_space->i_mmap维护了一棵基于vm_area_struct->shared.rb构建的增强型区间树(Interval Tree);- 当需要查找哪些进程
mmap了该文件的某一段偏移(Offset)时,区间树可以在 $O(\log N + M)$ 的极高时间复杂度内,直接返回所有包含该偏移区间的 VMA,彻底避免了线性全量扫描。
钟伊人的内核架构启示
- 联合体(Union)是内核极致节约内存的最高艺术:每个物理页由
struct page表示,在 64 位系统上其大小被严格死锁在 64 字节以内(占总物理内存的 1.5% 左右)。在如此逼仄的空间内实现图论级别的拓扑映射,依赖的就是指针低位 Tagging 与深度联合体复用。 - 读写分离与拓扑剪枝的平衡:Linux 没有在每次
mmap时暴力更新所有物理页,而是把拓扑关系保存在 VMA 层级,只有在真正需要逆向解析时才借助区间树按需推导。这种“延迟计算、索引加速”的思想在分布式存储系统设计中同样屡试不爽。 - 理解 rmap 才能看懂内存卡顿的真正元凶:当系统出现大规模进程
fork()并且随后发生内存争抢时,rmap_walk会在庞大的 AVC 链表与红黑树中高频遍历,导致内核锁anon_vma->rwsem争用飙升。搞懂底层的反向链路,你在排查性能剖析(perf top)中的内核热点函数时,才能一眼看穿本质。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 2
 0
- 0


 已为社区贡献52条内容

所有评论(0)