01Linux中断机制:从硬件到内核
Linux 的中断是「广义的中断体系」
狭义的中断:仅指外部硬件设备触发的中断(比如键盘、网卡、硬盘)
广义的中断(Linux 内核视角):所有打断 CPU 正常执行流程的事件,都属于中断体系。包括:
- 硬件中断(外部设备发来的异步事件)
- 异常(CPU 执行指令出错,比如除以 0、访问非法内存)
- 陷阱(主动触发的中断,比如系统调用)
- 信号(进程间的中断通知,比如 kill 命令)
学习中断到底有什么用?
- 写驱动必须会:硬件驱动的核心就是「中断处理函数」—— 硬件发中断,内核调用你写的驱动函数处理数据。不会中断就写不了驱动。
- 懂系统调用的本质:我们常用的
open、read、write这些函数,底层都是通过「软中断」陷入内核的。懂了中断,就懂了用户态怎么切换到内核态。 - 理解进程调度与通信:时钟中断是进程调度的触发源,没有时钟中断就没法多任务;信号本质是进程级的软中断。
- 调试内核 bug:内核 panic、段错误、栈溢出,本质上都是异常中断。懂了中断栈帧,就能顺着栈信息定位 bug。
中断的分类
第一大类:硬件中断
由外部硬件设备产生,通过中断控制器发给 CPU,是异步的 —— 你永远不知道它什么时候会来。
硬件中断又分两种:
- 可屏蔽中断:可以通过 CPU 的中断标志位关闭,比如键盘、串口、硬盘这些普通外设的中断。关闭后 CPU 暂时不响应。
- 不可屏蔽中断(NMI):不能被屏蔽,比如电源掉电、内存奇偶校验错误这种致命错误,必须立刻处理。
早期 x86 用 8259A 中断控制器管理 16 个硬件中断;现在 ARM 架构用 GIC 通用中断控制器,可管理上百个中断。
第二大类:软件中断
由 CPU 执行指令时主动产生,是同步的 —— 执行到某条指令就一定会触发。Linux 里也常叫「异常(Exception)」。
软件中断再细分三类,很多教材讲得很乱,我们按 x86 的标准分:
- 故障(Fault):可恢复的错误。比如缺页异常 —— 程序访问的内存不在物理内存里,触发缺页故障,内核把页面加载进来,再返回程序继续执行,程序自己都不知道发生过中断。
- 陷阱(Trap):主动触发的中断。最典型的就是系统调用—— 程序用
int 0x80指令主动触发中断,进入内核执行系统调用,执行完再返回用户态。 - 中止(Abort):严重错误,无法恢复。比如除以 0、访问非法内存,触发后程序直接被内核杀掉。
误区澄清:很多人以为「系统调用不属于中断」,不对。在 Linux 0.11 里,系统调用就是通过
int 0x80软中断实现的,属于中断体系的一部分。
Linux 0.11 中断相关的源码结构
核心文件分布
都在/kernel/目录下,分「汇编入口层」和「C 语言处理层」,分层设计 —— 和硬件打交道的用汇编,业务逻辑用 C。
| 层级 | 文件名 | 核心作用 |
|---|---|---|
| 汇编入口层 | asm.s | 通用异常与硬件中断的底层入口。所有硬件中断、CPU 异常,都先走到这里,保存上下文,再跳转到 C 函数。 |
| 汇编入口层 | system_call.s | 系统调用(int 0x80)的专属入口。因为系统调用是最高频的软中断,单独做了优化。 |
| C 语言处理层 | trap.c | 通用异常的 C 处理函数。比如除以 0、调试陷阱这些,对应的 C 函数都在这里。 |
| C 语言处理层 | irq.c | 硬件中断的注册、使能、屏蔽管理。 |
| C 语言处理层 | fork.c / signal.c | 对应系统调用分支的具体业务逻辑。 |
为什么要分层设计?
这是内核的经典设计思想:
- 汇编层只做和 CPU 架构强相关的事:保存寄存器、切换栈、跳转 C 函数。这些操作必须用汇编,C 语言控制不了寄存器。
- C 语言层做业务逻辑:具体中断该干什么,用 C 写,易读、可移植。以后换 CPU 架构,只需要改写汇编层,C 层不用动。
中断执行的完整流程
「硬件自动执行阶段」和「内核软件执行阶段」
前置条件:中断向量表已经初始化
内核启动的时候,会先在内存里建立一张中断向量表(IDT)。这张表就像一个「函数指针数组」,每一项对应一个中断号,存着这个中断的处理函数入口地址。
比如中断号 0 是除以 0 错误,中断号 14 是缺页异常,中断号 0x80 是系统调用。
阶段一:CPU 硬件自动完成的压栈
当中断触发时,CPU 硬件自动做以下事情,不需要写代码:
- 特权级检查与栈切换:如果是从用户态进入内核态,CPU 会自动切换到内核栈,保存用户栈的 SS 和 ESP,然后加载内核栈的 SS 和 ESP。如果中断发生时 CPU 本来就在内核态(ring0),那么 CPU 硬件确实不会执行“特权级检查与栈切换”这一步,也不会压入 SS 和 ESP
- 压入关键上下文:按顺序往栈里压入:EFLAGS(标志寄存器)→ CS(代码段)→ EIP(指令指针,也就是中断返回地址)→ 错误码(如果该中断有错误码)。
- 跳转处理函数:从中断向量表里找到对应中断号的处理函数地址,跳过去执行。
重点:这一步全是 CPU 硬件干的,内核代码只是提前设好了中断向量表。
阶段二:内核软件保存完整上下文(汇编层)
CPU 硬件只压了 EFLAGS、CS、EIP 这几个关键寄存器,但通用寄存器(EBX、ECX、EDX 等)和段寄存器(DS、ES 等)还没保存。
如果中断处理函数里要用这些寄存器,就会把原来的值覆盖掉,返回的时候程序就乱了。所以汇编入口代码会接着做:
- 把所有通用寄存器、段寄存器依次压栈
- 设置内核数据段,准备调用 C 函数
- 调用对应的 C 语言中断处理函数
阶段三:执行 C 语言中断处理函数(业务逻辑层)
这就是具体的中断处理逻辑了:
- 如果是键盘中断,就去读键盘扫描码
- 如果是缺页异常,就去磁盘加载页面
- 如果是系统调用,就去执行对应的内核函数
阶段四:中断返回,恢复上下文
处理完之后,又回到汇编代码:
- 依次弹出所有通用寄存器、段寄存器
- 执行
iret指令 —— 这是中断返回专用指令 - CPU 硬件自动弹出 EIP、CS、EFLAGS,如果有错误码也一起弹出
- 如果是用户态中断,自动切换回用户栈
- 程序回到中断前的位置,继续执行
完整流程小结: 中断触发 → CPU 硬件自动压栈关键寄存器 → 汇编代码压栈通用寄存器 → 调用 C 处理函数 → 汇编代码弹出通用寄存器 → CPU 硬件弹出关键寄存器 → 中断返回
上下文是什么
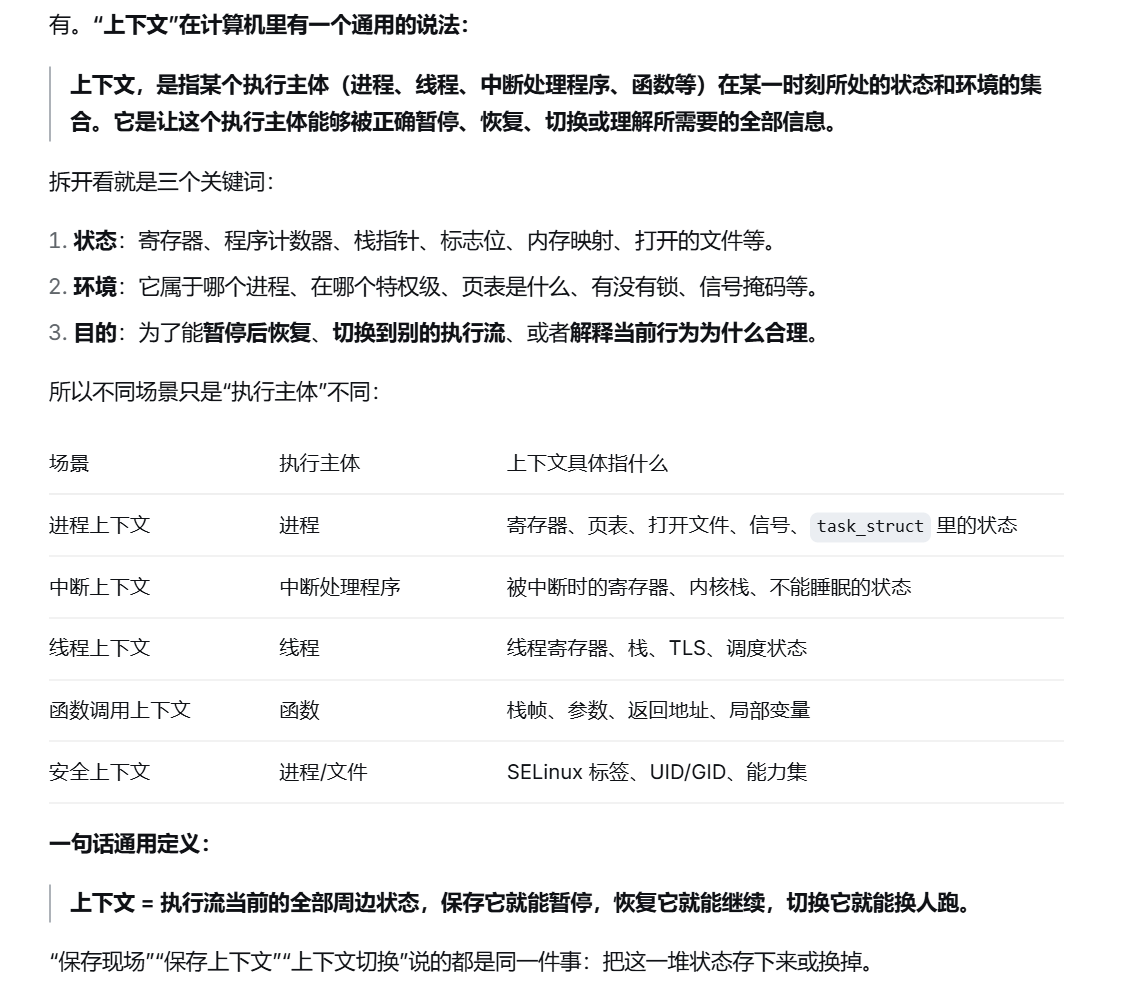
栈帧结构深度解析
5.1 栈的基本规则
x86 的栈是向下生长的:栈底在高地址,栈顶在低地址。压栈(push)就是栈顶往低地址走,出栈(pop)就是往高地址走。栈顶指针由 ESP 寄存器指向。
5.2 用户态触发的、带错误码的中断栈帧(从高地址到低地址)
高地址
+------------------+
|       SS         |  ← 用户栈栈段(仅用户态→内核态时存在)
+------------------+
|       ESP        |  ← 用户栈栈指针
+------------------+
|     EFLAGS       |  ← 标志寄存器
+------------------+
|       CS         |  ← 代码段选择子
+------------------+
|       EIP        |  ← 中断返回地址
+------------------+
|     错误码       |  ← 硬件自动压入,比如缺页异常会压入错误原因
+------------------+
|       EBX        |  \
+------------------+   |
|       ECX        |   |
|       EDX        |   |—— 汇编代码手动压入的通用寄存器
|       ESI        |   |
|       EDI        |   |
|       EBP        |  /
+------------------+
|    DS / ES / FS  |  ← 汇编代码手动压入的段寄存器
+------------------+  ← ESP现在指向这里(栈顶)
低地址
无错误码的中断栈帧
和上面几乎一样,只是少了「错误码」那一行。为了统一栈帧结构,内核会手动压入一个 0 来占位,这样后面 C 函数处理的时候,不用区分有没有错误码,栈的偏移量都是一样的。
这就是课程里说的「无错误码则压入零占位」的原因 ——统一栈帧格式,简化代码逻辑。
这套设计的核心优势是:无论什么类型的中断,栈帧结构完全一致,C 语言处理函数只需要接收一个栈指针参数,就能读取所有上下文信息。这是内核模块化设计的经典思想。
汇编与 C 代码的联动
很多人最困惑的点:汇编里怎么调用 C 函数?参数怎么传?返回值怎么收?
我们用 Linux 0.11 里最经典的system_call.s举例,讲清楚这个机制。
系统调用的触发:int 0x80
当用户态程序执行int 0x80指令,触发 0x80 号软中断,CPU 自动跳转到内核的system_call入口。
汇编层的核心操作
! system_call.s 简化版
system_call:
    pushl %ds        # 保存段寄存器
    pushl %es
    pushl %fs
    pushl %edx       # 保存通用寄存器
    pushl %ecx
    pushl %ebx

    movl $0x10, %edx # 加载内核数据段
    mov %dx, %ds
    mov %dx, %es

    call sys_call_table(,%eax,4)  # 调用C函数
这里最关键的是call sys_call_table(,%eax,4):
sys_call_table是 C 语言里定义的系统调用表,本质是函数指针数组eax里存的是系统调用号(比如 open 是 5,read 是 3)*4是因为每个函数指针占 4 字节- 本质就是:根据 eax 里的系统调用号,在数组里找到对应的 C 函数,调用它
参数与返回值的传递
- 参数传递:系统调用不用栈传参,而是用寄存器传参:ebx 存第一个参数,ecx 存第二个,edx 存第三个。用户态触发中断前把参数放进寄存器,内核汇编里保存完寄存器,C 函数就能直接读到。
- 返回值传递:C 函数的返回值存在 eax 寄存器里。中断返回时,eax 里的值会被带回用户态,用户程序就能拿到系统调用的返回值。
常见误区与关键问题解答
中断调用和普通函数调用有什么区别?
这是最核心的区别,很多人学完都没搞懂:
- 触发方式不同:函数调用是程序主动 call 的;中断是异步触发(硬件)或走中断门(软中断)。
- 栈不同:函数调用在同一个栈里;用户态中断会切换到内核栈。
- 保存的上下文不同:函数调用只保存返回地址(EIP);中断要保存 EIP、CS、EFLAGS,还有所有寄存器。
- 权限不同:函数调用在同一个特权级;中断会从用户态(3 级)切换到内核态(0 级)。
为什么要保存那么多寄存器?
因为中断处理函数也是普通的 C 代码,它会用到寄存器。如果不保存,就会把原来程序存在寄存器里的值覆盖掉,中断返回后程序就跑飞了。
本质就是:中断是「插入式」的,不能破坏被打断程序的任何状态。
为什么栈要向下生长?
这是 x86 的历史设计,好处是:栈底固定在高地址,栈顶向下延伸,堆从低地址向上延伸,两者相对生长,最大化利用内存空间。
异常处理函数:以 do_divide_error 为例
课程里提到 “大部分中断函数仅进行打印”,这是 Linux 0.11 作为早期教学内核的特点 —— 很多异常只做了最小实现。
函数的核心逻辑
do_divide_error(除以零错误)是典型的异常处理函数,它的工作只有三步:
- 接收栈指针作为入参,直接读取栈帧里的错误码、指令地址、寄存器值
- 向控制台打印错误类型、错误编号,以及出错时的段寄存器、指令指针等现场信息
- 终止当前进程(除以零属于不可恢复的中止类异常)
设计思想
所有异常处理函数都用栈指针作为唯一入参。因为所有中断的栈帧格式完全统一,C 函数不用关心是哪个中断触发的,直接通过栈偏移就能读取全部上下文,极大简化了代码结构。
补充:实际商用 Linux 中,很多异常是可以恢复的。比如缺页异常,内核会把缺失的页面从磁盘加载到内存,然后返回程序继续执行,程序本身都感知不到发生过中断。
核心前置知识:x86 特权级
课程提到了特权级,但没有展开,而这是理解「门机制」的关键,也是很多人学完都没搞懂的点。
x86 保护模式设计了 4 个特权级(0 级最高,3 级最低),Linux 只使用了两级:
- 内核态(CPL=0):操作系统内核运行的级别,可以访问所有硬件和全部内存
- 用户态(CPL=3):应用程序运行的级别,只能访问受限的内存和资源
和中断门相关的还有一个DPL(门描述符特权级):它是中断门本身的权限级别,代表「谁能主动触发这个中断」。
当程序用 int n 指令主动触发软中断时,CPU 会做权限检查:
当前程序的 CPL ≤ 门的 DPL 才能触发(数字越小特权越高) 简单说:调用者的权限不能比门的权限低。
两种陷阱门:set_trap_gate vs set_system_gate
trap_init 函数的作用就是初始化中断描述符表(IDT),给每个中断号配置对应的门描述符。课程里关于特权级的表述容易产生歧义,这里明确澄清:
表格
| 初始化函数 | 门类型 | 门的 DPL | 典型用途 | 触发规则 |
|---|---|---|---|---|
set_trap_gate | 陷阱门 | 0 | 除以零错误、缺页异常、NMI 不可屏蔽中断 | 仅 CPU 硬件自动触发,用户态程序无法用 int 指令主动调用 |
set_system_gate | 陷阱门 | 3 | 系统调用(int 0x80)、单步调试陷阱 | 用户态程序可通过 int 指令主动触发,内核态也可调用 |
误区澄清:课程里 “前者特权级为 3,后者特权级为 0” 的表述不准确。准确来说:
- 普通异常门(set_trap_gate)权限更高(DPL=0),禁止用户主动触发,只能由硬件异常触发,防止恶意程序破坏系统
- 系统调用门(set_system_gate)对用户开放(DPL=3),允许应用程序主动进入内核请求服务
IDT 与中断处理函数表的关系
很多人会混淆这两个表,其实它们分属硬件层和软件层:
- IDT(中断描述符表):硬件层面的表,存在物理内存中,每个表项是一个符合 x86 规范的门描述符。CPU 收到中断号后,直接查这张表找到处理入口。
- 中断处理函数表:内核软件层面的函数指针数组,保存了每个中断对应的 C 处理函数地址。
trap_init 做的事情,就是把 C 处理函数地址封装成符合硬件要求的门描述符,写入 IDT,建立「中断号 → IDT 门 → 汇编入口 → C 处理函数」的完整映射。
系统调用的完整执行链路
系统调用是用户态程序主动进入内核的唯一正规方式,本质就是权限可控的软中断。我们把完整流程串起来:
- 用户态准备:应用程序把系统调用号存入
EAX寄存器,参数依次存入EBX、ECX、EDX - 触发软中断:执行
int 0x80指令,触发 0x80 号软中断 - 硬件自动压栈:CPU 切换到内核态,自动压入用户栈的 SS、ESP,以及 EFLAGS、CS、EIP
- 汇编保存上下文:进入
system_call.s专属入口,压入通用寄存器和段寄存器 - 查表调用 C 函数:以 EAX 中的系统调用号为下标,索引
system_call_table函数指针数组,跳转到对应的内核函数 - 处理返回:C 函数的返回值存入 EAX,汇编层依次弹出寄存器,执行
iret中断返回 - 用户态取结果:应用程序从 EAX 寄存器中读取系统调用的返回值
系统调用 vs 普通中断
| 对比维度 | 普通硬件 / 异常中断 | 系统调用(int 0x80) |
|---|---|---|
| 触发主体 | 硬件外设 / CPU 异常,异步发生 | 用户程序主动触发,同步发生 |
| 门权限 DPL | 0,用户态不可主动触发 | 3,用户态可主动触发 |
| 参数传递 | 无入参,通过栈帧读取上下文 | 通过寄存器传递调用参数 |
| 返回值 | 无统一返回值 | 通过 EAX 返回调用结果 |
| 入口代码 | asm.s 通用入口 | system_call.s 专属优化入口 |
模块二:进程管理核心 —— 时间驱动的调度体系
进程管理的本质是分时复用 CPU,让多个进程看起来 “同时运行”。而整个分时系统的驱动力,就是时钟中断。
进程管理的五大核心模块
课程提到了五个方面,对应到内核源码就是:
- 进程运转机制:进程状态、上下文、内核栈
- 进程创建:fork 机制、copy_process
- 进程调度:schedule 函数、时间片与优先级
- 进程退出:exit、wait、僵尸进程处理
- 进程间通信(IPC):信号、管道
系统时间的两套基准
课程里提到了 RTC 和 jiffies,这里纠正一个表述不严谨的地方:
RTC(实时时钟)不是 CPU 内部的,它是主板上的独立芯片,靠纽扣电池供电,关机也会继续走时,用来提供「墙上时间」。 CPU 内部 / 主板上的是可编程定时器(8253/8254),用来产生周期性的时钟中断。
Linux 0.11 维护了两套时间基准:
① 墙上时间:start_time
内核启动时调用 make_time 函数,从 RTC 中读取当前年月日时分秒,转换成自 1970 年 1 月 1 日 00:00:00 以来的总秒数,存入全局变量 start_time。
两个关键细节:
- BCD 转二进制:CMOS 里的时间是 BCD 格式(一个字节存两位十进制数),内核必须转换成普通二进制才能计算
- 闰年校验:计算总秒数时会做闰年判断,保证时间基准准确
start_time 是系统的绝对时间基准,文件的创建时间、进程的时间戳都基于这个值。
② 运行时间:jiffies
jiffies 是内核的全局计数器,代表系统启动以来的时钟滴答次数。 Linux 0.11 配置的时钟频率是 100Hz,也就是每 10 毫秒触发一次定时器中断,每触发一次,jiffies 就加 1。 换算关系:1 jiffy = 10ms,1秒 = 100 jiffies。
jiffies 是整个多任务系统的脉搏,进程调度、定时任务、时间统计全靠它驱动。
时钟中断的核心:do_timer 函数
每次时钟中断触发,最终都会调用 do_timer 函数,它做三件核心的事:
- 全局时间推进:jiffies 自增 1,系统脉搏向前走一格
- 进程时间记账:根据当前进程的特权级(CPL)分别统计:
- 当前在用户态:当前进程的
utime(用户态运行时间)+1 - 当前在内核态:当前进程的
stime(内核态运行时间)+1
- 当前在用户态:当前进程的
- 定时任务处理:遍历内核定时器链表,执行到期的定时回调函数
为什么要区分 utime 和 stime? 这样可以精确统计每个进程在用户态和内核态分别消耗了多少 CPU 资源,这也是
ps、top命令中 “用户时间”“系统时间” 的来源。
进程调度的核心数据
每个进程对应一个 task_struct 结构体(也叫进程控制块 PCB),和调度相关的两个核心变量:
priority:进程的优先级,创建时赋值,数值越大优先级越高counter:进程的剩余时间片,单位是 jiffies,是调度器的核心决策依据
调度触发的时机
什么时候会调用 schedule 函数切换进程?分两种情况:
① 主动调度
进程主动调用 sleep、wait 等阻塞函数,主动放弃 CPU,进入等待状态。
② 被动调度(时间片耗尽)
时钟中断中发现当前进程的 counter 已经减到 0,并且当前处于用户态,就会设置调度标记;等中断返回用户态时,触发调度。
关键设计:Linux 0.11 是非抢占式内核 如果进程正在内核态运行,哪怕它的时间片用完了,也不会立刻被调度走,必须等它从内核态返回用户态时,才会检查并执行调度。 原因:内核态代码经常操作临界资源(比如全局链表、硬件寄存器),强行抢占会引发竞态问题。早期内核为了简化设计,采用非抢占式。
调度算法深度拆解
Linux 0.11 采用优先级时间片轮转调度算法,核心就是 schedule 函数,逻辑可以拆解为三步:
- 遍历筛选:遍历系统中所有 64 个进程,跳过阻塞、停止等不可运行的进程
- 选出最优:在所有就绪进程中,选出 counter 值最大 的进程
- 重新分配:如果所有就绪进程的 counter 都为 0,就用公式重新计算所有进程的时间片:
counter = counter / 2 + priority
这个公式的设计哲学
很多课程只讲 “时间片轮转”,但 counter/2 + priority 才是早期调度器的精髓。
- 优先级的基准作用
priority是时间片的基准值。优先级越高,每次重新分配得到的时间片基数越大,能获得更多 CPU 时间。 - counter/2 的衰减机制
- CPU 密集型进程:一直占着 CPU 跑,时间片很快用完,counter 变成 0;重新分配后就是 priority 的值,和其他进程同一起跑线
- IO 密集型进程:经常等待磁盘、键盘 IO,大部分时间在阻塞,counter 用不完;重新分配时会累积剩余值,counter 会比其他进程大,下次优先被调度
- 效果:IO 密集型进程响应更快,不会因为频繁阻塞而 “饿死”,同时 CPU 密集型进程也能充分利用计算资源
- 公平性保障 所有进程的时间片都会动态衰减,不会出现高优先级进程一直霸占 CPU、低优先级进程永远轮不到的情况。
补充:Linux 0.11 最多支持 64 个进程,就是因为
task进程数组的大小固定为 64。
全局主线总结
学到这里,你应该能把中断和进程管理串成一条完整的内核运转主线:
硬件时钟中断 → jiffies 自增 → 进程时间记账 → 时间片耗尽触发调度 → schedule 选出下一个进程 → 切换上下文 → 新进程运行
中断是内核的 “输入系统”,负责响应所有内外事件;而进程调度是内核的 “大脑”,负责分配 CPU 资源。两者结合,才构成了多任务操作系统的核心骨架。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)